インテリジェントルーティング
概要
インテリジェントルーティング(モデルルーティングとも呼ばれます)は、リクエストを上流に送る前に、そのリクエストが最終的に使うモデルを決定します。呼び出し側はいつも通りモデル名を指定するだけで、ゲートウェイが管理者の設定したルールに従ってモデルを書き換え、必要に応じてプライマリモデルの失敗後に候補モデルへ自動で切り替えます。
主な用途:
| シナリオ | 説明 |
|---|---|
| 自動振り分け | 呼び出し側は 1 つの仮想モデル名(例:og-auto)を指定し、ゲートウェイがリクエストの複雑度に応じて簡単・中程度・複雑の 3 段階のモデルを選択します。簡単な質問には安価なモデル、複雑なタスクには高性能なモデルを使います |
| モデルの置き換えと段階的移行 | あるモデルへのリクエストを、全部または一定割合だけ別のモデルに切り替えます。呼び出し側のコード変更は不要です |
| フェイルオーバー | あるモデルの呼び出しが最終的に失敗した場合、候補モデルへ順番に切り替え、単一モデルの障害による失敗を減らします |
| 条件ルーティング | 条件を満たすリクエストを指定のモデルに切り替えます。たとえば長い入力は長コンテキストモデルへ、画像付きは視覚モデルへ、ツール呼び出しは関数呼び出しに強いモデルへ、特定のテナントやクライアント(Claude Code など)は専用のモデルへ送ります |
インテリジェントルーティングは、リクエストの内容(タスクの複雑度など)に基づいてどのモデルを使うかを選びます。プロバイダールーティングは、遅延、価格、可用性などの稼働指標に基づいて同じモデルのプロバイダーを選ぶもので、トラフィック管理に当たります。両者は異なる 2 つの層です:
| インテリジェントルーティング(本ページ) | プロバイダールーティング | |
|---|---|---|
| 決めるもの | どのモデルを使うか | 同じモデルをどのプロバイダーで処理するか |
| 失敗時 | 別のモデルでリクエストし直す | 同じモデルのプロバイダー間で再試行する |
| 課金 | 書き換え後のモデルで課金 | 課金対象のモデルは変わらない |
| 実行順序 | 先 | 後:インテリジェントルーティングがモデルを選んだ後、毎回プロバイダールーティングを経由します |
仕組み
| 概念 | 説明 |
|---|---|
| ルール | 一致条件と処理内容の組み合わせ。ルールは優先度順に評価され、最初に一致したルールが適用されます |
| 対象モデル | 一致後に使うモデル。複数指定して重みを設定すると、比率に応じてランダムに選ばれます |
| 候補モデル | プライマリモデルが最終的に失敗したときに順番に試すモデル |
| 仮想モデル | ゲートウェイ内にだけ存在するモデル名(例:og-auto)。プロバイダー側に存在したり料金が設定されたりしている必要はありません |
| 複雑度 | SIMPLE(簡単)、MEDIUM(中程度)、COMPLEX(複雑)。ゲートウェイがリクエスト内容から判定します |
どのルールにも一致しないリクエストはそのまま転送され、モデルは変わりません。ルール自体にエラーがある場合(条件の書き方の誤りなど)、そのルールだけがスキップされ、リクエストはブロックされません。
前提条件
- 管理者が対象の Gate インスタンスでインテリジェントルーティングプラグインを有効化し、ルーティングルールを設定済みであること。
- ルールで使うすべての対象モデルと候補モデルが Providers & Models で接続・価格設定済みで、呼び出し側のグループに利用可能なプロバイダーがあること。
- 呼び出し側の API Key で利用可能なモデルを制限している場合、その一覧にこれらの対象モデルと候補モデルが含まれていること。詳しくは課金と権限を参照してください。
対応するエンドポイント
| エンドポイントの種類 | パス | モデルの取得元 |
|---|---|---|
| OpenAI 形式 | POST /v1/chat/completions | リクエストボディの model(ストリーミングを含む) |
| OpenAI Responses 形式 | POST /v1/responses | リクエストボディの model(ストリーミングを含む) |
| Anthropic 形式 | POST /v1/messages | リクエストボディの model(ストリーミングを含む) |
| 旧版の補完 | POST /v1/completions | リクエストボディの model(ストリーミングを含む) |
| Gemini ネイティブ形式 | POST /v1beta/models/{model}:generateContent、:streamGenerateContent | URL 内のモデル。リクエストボディの model は使われません |
管理者の設定
管理画面はプレビュー版です
このセクションで紹介するシナリオ設定、ドライラン、ルーティングモニターの画面は現在プレビュー版で、OneGateway コンソールの「Plugins → Intelligent Routing」から開けます。Gate のルール定義ファイルを直接編集するか、Gate のルール管理 API(中国語)を使って設定とドライランを行えます。
よく使う用途は、シナリオとしてモデル名を入力するだけで設定できます。下表の効果はシナリオで生成されるルールの動作です。ルールファイルを直接記述する場合は、記述したルールに従って動作します:
| シナリオ | 入力する内容 | 効果 |
|---|---|---|
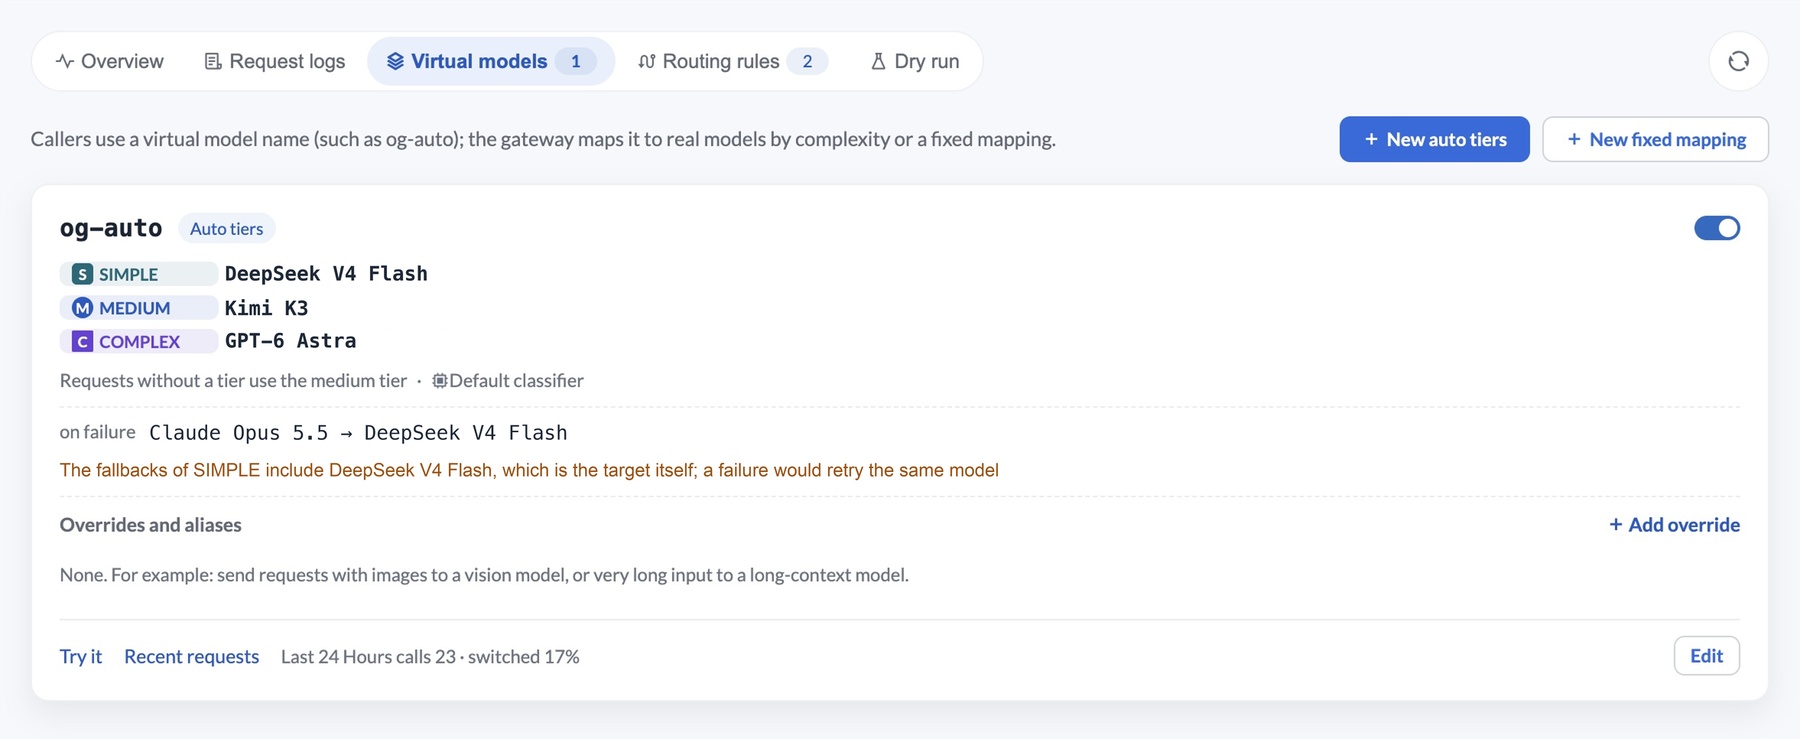
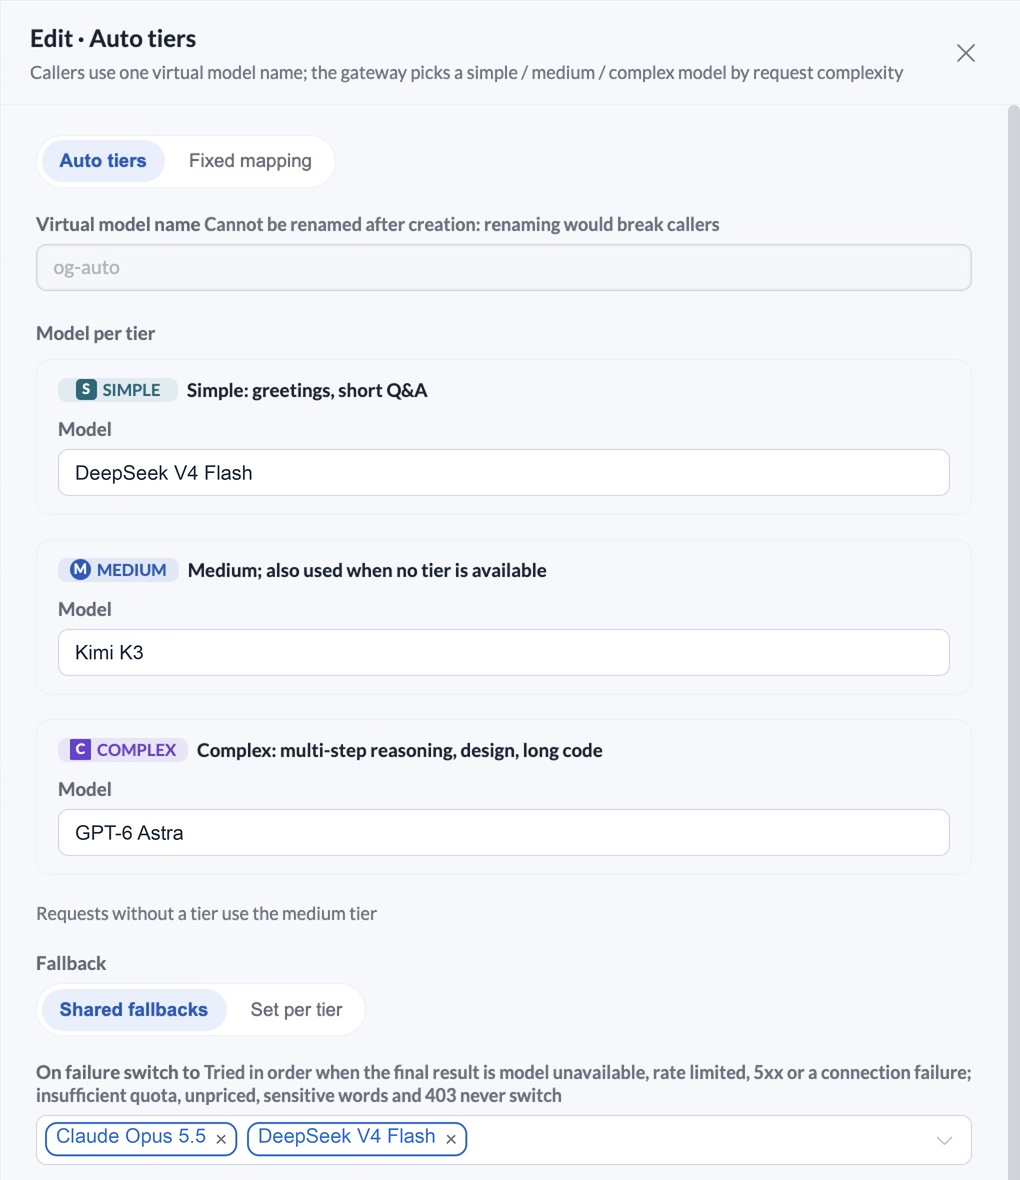
| 仮想モデル · 複雑度で振り分け | 仮想モデル名と、簡単・中程度・複雑の各段階で使うモデル | 3 段階のルールに加えて、複雑度を判定できない場合(画像のみのリクエストなど)に中程度のモデルを使う予備のルールも生成されます |
| 仮想モデル · 固定マッピング | 仮想モデル名と、置き換え先のモデル。複数のモデルと割合も指定できます | 呼び出し側が仮想モデル名(例:og-coding)を指定すると、ゲートウェイは常に指定の実モデルに書き換えます |
| 置き換えと分散 | 元のモデルと、置き換え先のモデル。複数のモデルと割合も指定できます | 1 つのモデルなら全部を置き換えます。複数のモデルなら割合に応じて振り分け(段階的移行や負荷分散)、元のモデルを含めて一部のトラフィックを残すこともできます |
| フェイルオーバー | プライマリモデルと、順番を付けた候補モデル | モデルは変えず、失敗時だけ切り替えます |
| モデルエイリアス | いくつかの別名と、まとめ先のモデル | 別名をまず対象モデルに書き換え、その後は対象モデルの他のシナリオがそのまま適用されます |
| 条件ルーティング | 対象のモデル(ワイルドカード可。空欄はすべてのモデル)、条件、切り替え先のモデル | 条件は組み合わせられます:長コンテキスト(推定トークン数がしきい値以上)、画像を含む、ツールあり、テナント、リクエストヘッダー(user-agent によるクライアントの識別など)、推論の強度、プロトコル、ストリーミング、複雑度 |
フェイルオーバー以外のどのシナリオにも、失敗時の候補モデルを任意で付けられます。自動振り分けの 3 段階は候補を共有することも、段階ごとに設定することもできます。必要であれば、1 つのシナリオだけ切り替え条件(どのステータスコード、どの追加エラーコードで切り替えるか、最大試行回数)を個別に設定でき、他のシナリオはグローバル設定のままです。詳しくは失敗時の自動切り替えを参照してください。
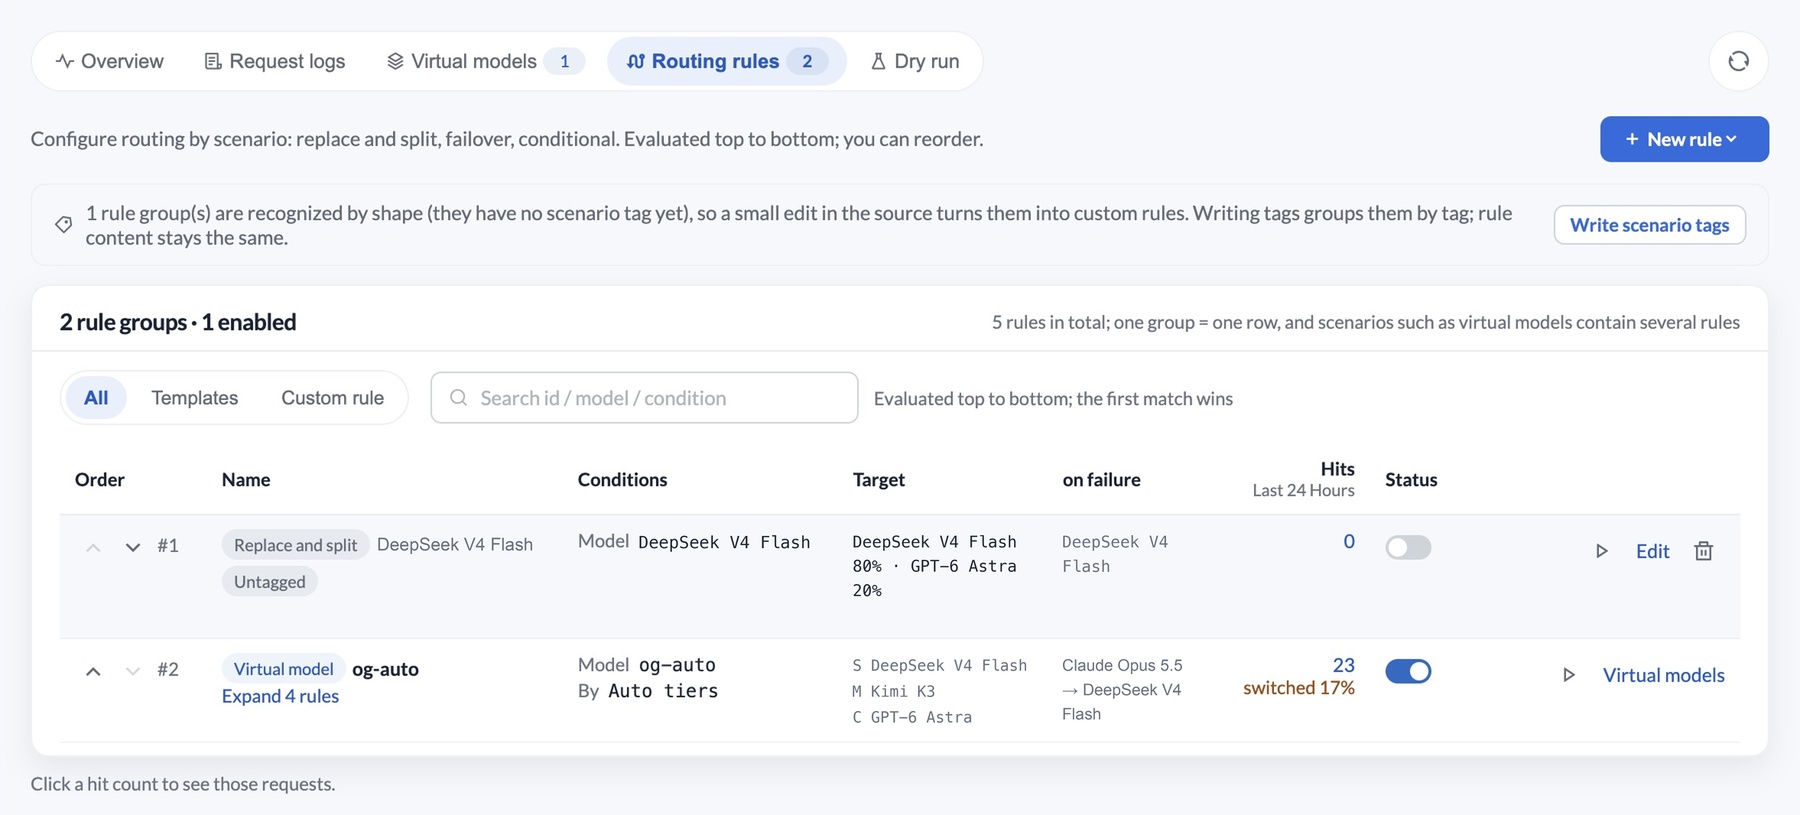
仮想モデルは専用のページで管理し、各カードにはその仮想モデルに適用される条件ルーティング(画像付きは視覚モデルへ、など)も表示され、そこから直接追加できます。その他のシナリオと手書きのルールはルール一覧にまとめて一致を判定する順番に並び、最初に一致したものが適用されます。条件ルーティングは既定で同じモデルの他のルールより前に置かれ、行頭の上下ボタンで順番を変えられます。優先度は保存時に自動で割り当てられます。同じリクエストをすべて引き受けるシナリオの後ろに置かれたシナリオは一致することがなく、画面に警告が表示されます。
各シナリオは 1 つ以上のルールから成り、ルールにはシナリオのタグ(scenario)が付きます。タグは画面でルールをまとめるためだけに使われ、ルーティングの結果には影響しません。ルールの原文を手で編集してシナリオのテンプレートと合わなくなったルールはカスタムルールとして表示され、原文でのみ変更できます。
保存前にサンプルリクエストでドライランを実行し、どのルールに一致するか、どのモデルに書き換わるか、どの複雑度と判定されるかを確認できます。ドライランはリクエストを対象モデルに転送せず、このリクエストのモデル生成費用も発生しません。ただし、LLM または Embedding 分類を有効にしている場合は、設定した分類サービスが呼び出されるため、プラットフォーム側の費用が発生する場合があり、サンプルのテキストもそのサービスに送信されます。
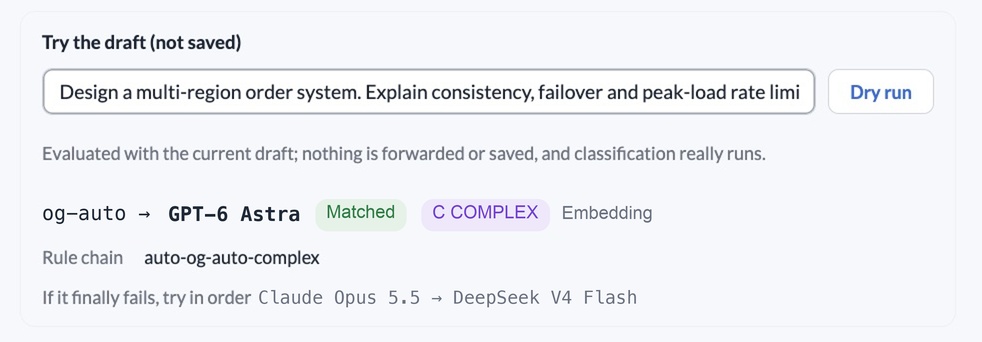
ルールは保存するとすぐに反映され、ゲートウェイの再起動は不要です。より複雑な条件(リクエストヘッダー、テナント、プロトコル、入力長などの組み合わせ、チェーンルールなど)が必要な場合は、ルールの原文で記述します。フィールドと例は技術リファレンス(中国語)を参照してください。
日常の設定とプラットフォームの設定
管理画面では設定を 2 つのレベルに分け、別々に配置しています:
| レベル | 対象 | 内容 |
|---|---|---|
| 日常の設定 | AI Token を理解し、プラットフォームの機能をある程度使いこなせる組織(会社)管理者 | 仮想モデル、置き換えと振り分け、フェイルオーバー。長いコンテキスト・画像付き・ツール付き・クライアントを組み合わせた条件ルーティング。シナリオの有効化・順番・候補モデル。用意された分類器の選択。ドライラン |
| プラットフォームの設定 | OneGateway のプラットフォーム管理者 | 分類器、全体の切り替えポリシー、利用可能なモデルの範囲、プラグインのオン/オフと実行パラメーター。シナリオごとの切り替え条件。モデルのエイリアス。テナントや推論の強度による振り分け。カスタムルールと原文の編集。アラートのしきい値 |
管理画面の右上にある視点ボタンで「組織管理者の視点」と「プラットフォーム管理者の視点」を切り替えられます。組織管理者の視点では日常の設定だけが表示され、プラットフォーム管理者の視点ではすべてが表示されます。プラットフォームの設定は、メニューの「プラットフォームの設定」グループ、または日常のページ内で「プラットフォームの設定」ラベルの付いた折りたたみ領域にあります。誤って設定するとすべてのリクエストに影響するため、プラットフォーム管理者が管理することをおすすめします。
アラート
次のような場合、ページ上部にアラートが表示されます。しきい値はプラットフォームの設定で調整できます:
- あるシナリオで直近 1 時間にレート制限や上流の障害で失敗した割合が高い。候補モデルの追加を検討してください。
- 候補モデルに切り替えたリクエストの割合が高い。プライマリモデルが不安定な可能性があります。
- 複雑度が必要なリクエストのうち、複雑度を得られなかった割合が高い。プラットフォーム管理者が分類器を確認する必要があります。
無効なキー、クォータ不足、料金未設定のモデルなど呼び出し側の問題は、モデルを切り替えても解決しないため失敗率に含めず、概要ページで別に表示します。
複雑度の判定方法
複雑度は、プラットフォームが設定した分類器で判定します。方法は次のとおりです:
| 方法 | 仕組み |
|---|---|
| ローカル採点 | 長さ、コード関連の語、推論を求める表現、技術用語、あいさつや簡単な質問などの手がかりから採点し、点数で段階を決めます。モデルを呼び出さないため、待ち時間も費用もほとんど増えません |
| ローカル優先 | まずローカルで採点します。あいさつや短い質問など手がかりがはっきりした簡単なリクエストはその場で決め、判断がつかないものだけ LLM 分類に回します |
| LLM 分類 | ユーザーのリクエストをプラットフォームが用意した小さなモデルに渡し、どの段階かを判定させます |
| Embedding 例文マッチング | 各段階にあらかじめ用意した例文との類似度を比べ、最も近い段階に分類します |
LLM 分類と Embedding 例文マッチングはプラットフォーム自身のモデルと認証情報を使い、呼び出し側の API Key やモデルは使いません。判定のたびに分類モデルの呼び出しが 1 回増えます。ローカル優先では、判断がつかない場合だけ呼び出します。管理者は別の方法を予備に設定でき、主な方法が失敗したときに使われます。ローカル採点を予備にすると、必ず段階が付きます。
ローカル採点は言い回しだけを見るため、モデルより判定が粗くなります。単独では評価用データの約半分しか正しく判定できませんでした。分類の呼び出しを約 4 割減らしつつ LLM に近い精度を保てる「ローカル優先」をおすすめします。あくまでルーティングの目安であり、呼び出し側は言い回しで段階に影響を与えられます。
独立した LLM 分類モデルを 2 つ設定することもできます。主モデルが成功した場合、予備モデルは呼び出しません。主モデルのタイムアウト、呼び出し失敗、無効な分類結果、同時実行数の上限に達した場合のみ予備モデルを使用します。次の分類では再び主モデルを優先するため、復旧後は自動的に主モデルへ戻ります。両方が失敗した場合にのみ段階が付かなくなります。予備モデルの段階は現在のリクエストだけに適用し、セッションには保存しません。異なるサービス提供者のエンドポイントと認証情報を使うと、共通障害を減らせます。
分類は業務モデルの呼び出し前に実行されるため、待ち時間はストリーミングの最初のバイトまでの時間と非ストリーミングの応答時間に直接加算されます。新しい分類では毎回主モデルを優先するため、主モデルが継続的にタイムアウトする場合は毎回そのタイムアウトを待ってから予備を使用します。管理者は実測遅延に基づいて主モデルのタイムアウトを短めに設定し、認証情報の検証と主・予備の分類の最大待ち時間を全体の遅延予算に含めてください。
分類器を設定していない場合は複雑度を判定しません
管理者が分類器を設定していない場合や、分類モデルが一時的に利用できない、またはタイムアウトして予備もない場合、そのリクエストには複雑度が付かず、複雑度で振り分けるルールには一致しません。リクエストは後続のルールで処理されます。自動振り分けのシナリオでは予備のルールが生成され、この場合は中程度のモデルを使います。
既定ではユーザー本人が書いた直近のメッセージだけを判定に使い、管理者は message_window で直近の複数件に広げられます。システムプロンプト、アシスタントの返答、ツールの返却結果は常に対象外で、Claude Code などのツールが自動で付けるタグも取り除かれます。
仮想モデルごとに別の分類器を使えます。管理者は「名前付き分類器」を追加で作成し(たとえば雑談用の入口はローカル採点、コーディング用の入口は LLM)、仮想モデルにそのいずれかを選ばせることができます。指定のない仮想モデルは既定の分類器を使います。セッションの複雑度は仮想モデルの分類器ごとに別々に記録され、互いに影響しません。
各方法の違い、パラメーター、精度は複雑度の判定(中国語)を参照してください。
複雑度を判定するタイミング
ルールは優先度順に評価され、複雑度を必要とする条件に初めて出会ったときに判定します。判定は分類器ごとに 1 リクエストにつき最大 1 回です。チェーンしたルールが別々の名前付き分類器を使う場合は、それぞれ 1 回ずつ判定し、オーバーヘッドも積み重なります。それより前に複雑度と関係ないルールに一致した場合は判定せず、オーバーヘッドもありません。ただし、いったん判定が行われた場合は、最終的に一致したのが複雑度と関係ないルールでも、判定のオーバーヘッドは発生しています。
セッションの複雑度
有効にすると、同じセッション内の複雑度は上がるだけで下がりません。長い会話の前半で複雑と判定された場合、その後の短い追加質問も複雑のモデルを使い続けるため、モデルの行き来によってプロバイダー側のコンテキストキャッシュが無効になるのを防げます。セッションに記録されるのは、リクエストが成功し、かつ設定した分類器による判定だった場合だけです。分類器の失敗時に一時的に使われた予備の判定は、そのリクエストにだけ適用されます。セッションが有効期限を超えて使われなかった場合や、管理者が主な判定方法を変更した場合(分類モデル、指示、例文の変更など)は、判定をやり直します。予備の方法の追加・削除・調整だけなら、既存のセッションには影響しません。セッションは hcd-og-session-id リクエストヘッダーで識別し、Claude Code 標準のセッションヘッダーも認識します。異なる API Key は、同じセッション ID を使っても互いに影響しません。
クイック検証
自動振り分けのシナリオが設定されていることを確認します(仮想モデル og-auto を例にします)。アドレスと API Key を実際の値に置き換え、簡単なリクエストを送信します:
curl -sS -i 'https://your-gateway.example.com/v1/chat/completions' \
  -H 'Authorization: Bearer <ONEGATEWAY_API_KEY>' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "og-auto",
    "messages": [{"role": "user", "content": "こんにちは、今日の天気はどうですか?"}]
  }'
その他はそのままで content だけを置き換え、順に確認します:
| 確認項目 | content | 期待されるレスポンスヘッダー |
|---|---|---|
| 簡単なリクエスト | こんにちは、今日の天気はどうですか? | og-route: ROUTED、og-route-tier: SIMPLE、og-route-model が簡単のモデル |
| 中程度のリクエスト | このログのエラーの原因を分析してください | og-route-tier: MEDIUM、og-route-model が中程度のモデル |
| 複雑なリクエスト | システムアーキテクチャの設計とトレードオフの分析を求める長い文章 | og-route-tier: COMPLEX、og-route-model が複雑のモデル |
ストリーミングリクエスト("stream": true)でも同じレスポンスヘッダーが返り、最初の出力より前に確認できます。ルーティングでどのモデルが選ばれたかは og-route-model で判断してください。レスポンスボディの model はプロバイダーが返すモデル名で、プロバイダーがモデルをマッピングしている場合やバージョン付きの名前を使う場合は、og-route-model と異なることがあります。
課金と権限
ルーティング後のモデルで課金されます。og-auto へのリクエストが書き換えられたモデル(つまり og-route-model)のプラットフォーム上の価格で課金され、プロバイダー側で確認・記録されるのも書き換え後のモデルです。仮想モデル名自体に価格を設定する必要はありません。実際の費用はリクエストログの課金明細で確認してください。
モデルの許可リストを設定した API Key
プロバイダー側は、API Key のモデル許可リストを書き換え後のモデルで検証します。許可リストに og-auto だけを追加しても意味がありません。ルールで使われる可能性のあるすべての対象モデルと候補モデルを追加しないと、リクエストは 403 を返し、403 では切り替えも発生しません。
候補モデルに切り替えた場合、失敗した試行には課金されず、最終的に成功した 1 回分だけが課金されます。
失敗時の自動切り替え
一致したルールに候補モデルが設定されている場合、プライマリモデルが最終的に失敗した後(プロバイダールーティングでの再試行でも失敗した後)、ゲートウェイは候補モデルを順番に試します。
| プライマリモデルの応答 | 切り替え | 理由 |
|---|---|---|
| 503 利用可能なプロバイダーなし、429 レート制限、500 / 502 / 503、529 プロバイダー過負荷、接続失敗 | 切り替える | モデルが一時的に利用できず、別のモデルなら成功する可能性がある |
| 504 / 524 タイムアウト | 既定では切り替えない | 切り替えると待ち時間が倍増するため。管理者が切り替えに変更できます |
| 400 料金未設定、403 アクセス権なし、クォータ不足 | 切り替えない | 別のモデルでも解決せず、切り替えで権限を回避されるおそれがある |
| センシティブワードによる拒否 | 切り替えない | 同じ内容は他のモデルでも拒否される |
- 既定では最大 3 回(初回を含む)まで試行します。
- 以上はグローバルの既定値です。1 つのシナリオだけ切り替え条件を個別に設定できます。たとえば長コンテキストのシナリオで 504 も切り替え対象にしたり、コンテキスト長超過のエラーコードで切り替えたりできます。影響はそのシナリオだけで、クォータ不足、料金未設定、センシティブワードによる拒否は常に切り替えません。
- ストリーミングリクエストは出力開始前にだけ切り替えます。出力が始まった後に上流が中断しても、別のモデルには切り替えません。
- 候補モデルもすべて失敗した場合は、最後の試行のエラーを返します。
- 切り替えが発生したリクエストはセマンティックキャッシュに書き込まれません。
効果の確認とトラブルシューティング
まずレスポンスヘッダーを確認します:
| レスポンスヘッダー | 意味 |
|---|---|
og-route | PASS どのルールにも一致しない、ROUTED ルールに一致、FALLBACK 切り替えが発生(結果はステータスコードで確認)、BYPASS 呼び出し側がルーティングをスキップ、ERROR ルーティング自体のエラーで元のモデルのまま転送 |
og-route-rule | 一致したルールの ID(ID のみで、条件は表示しない) |
og-route-model | ルーティング後にプロバイダーへ送られたモデル(切り替えが発生した場合は最後に試行したモデル)。課金にもこのモデルが使われます |
og-route-requested-model | 呼び出し側が元々指定したモデル。モデルが書き換えられた場合のみ付きます |
og-route-attempts | 上流への試行回数(初回を含む)。1 より大きければ切り替えが発生しています |
og-route-tier | 複雑度。複雑度を判定した場合のみ付きます |
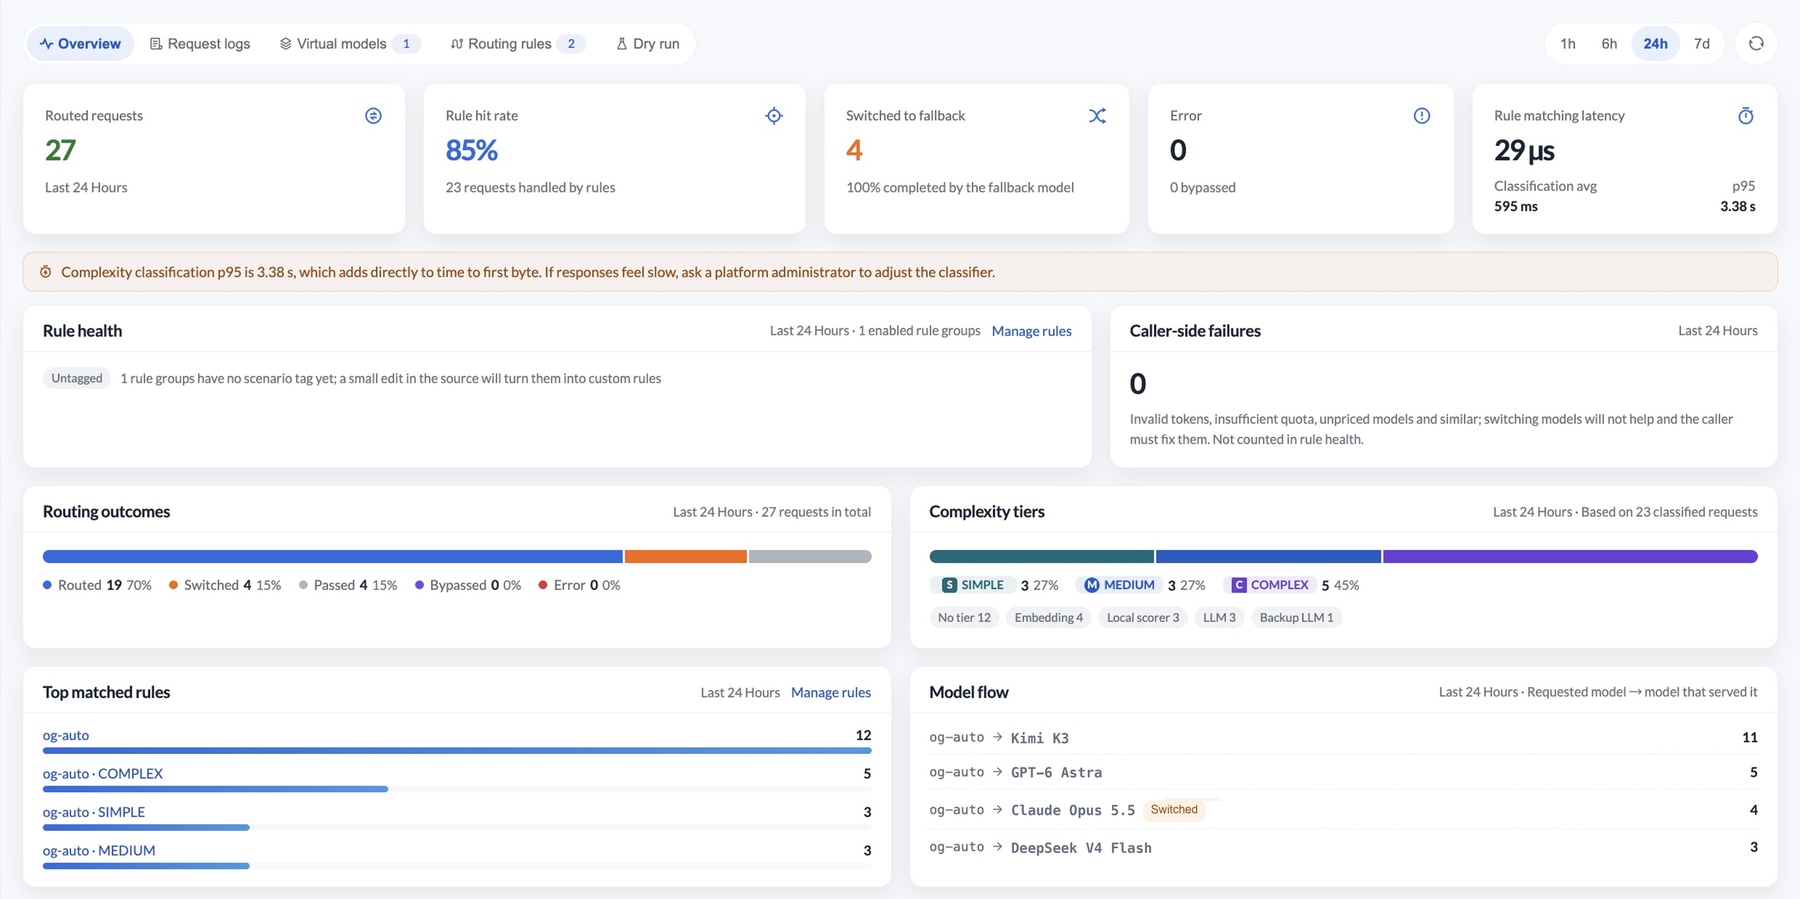
ログストレージを有効にすると、管理者はルーティングモニターで時間範囲ごとにルーティング結果の分布、複雑度の分布、「指定されたモデル → 実際のモデル」の流れを確認し、個々のリクエストまで掘り下げられます。
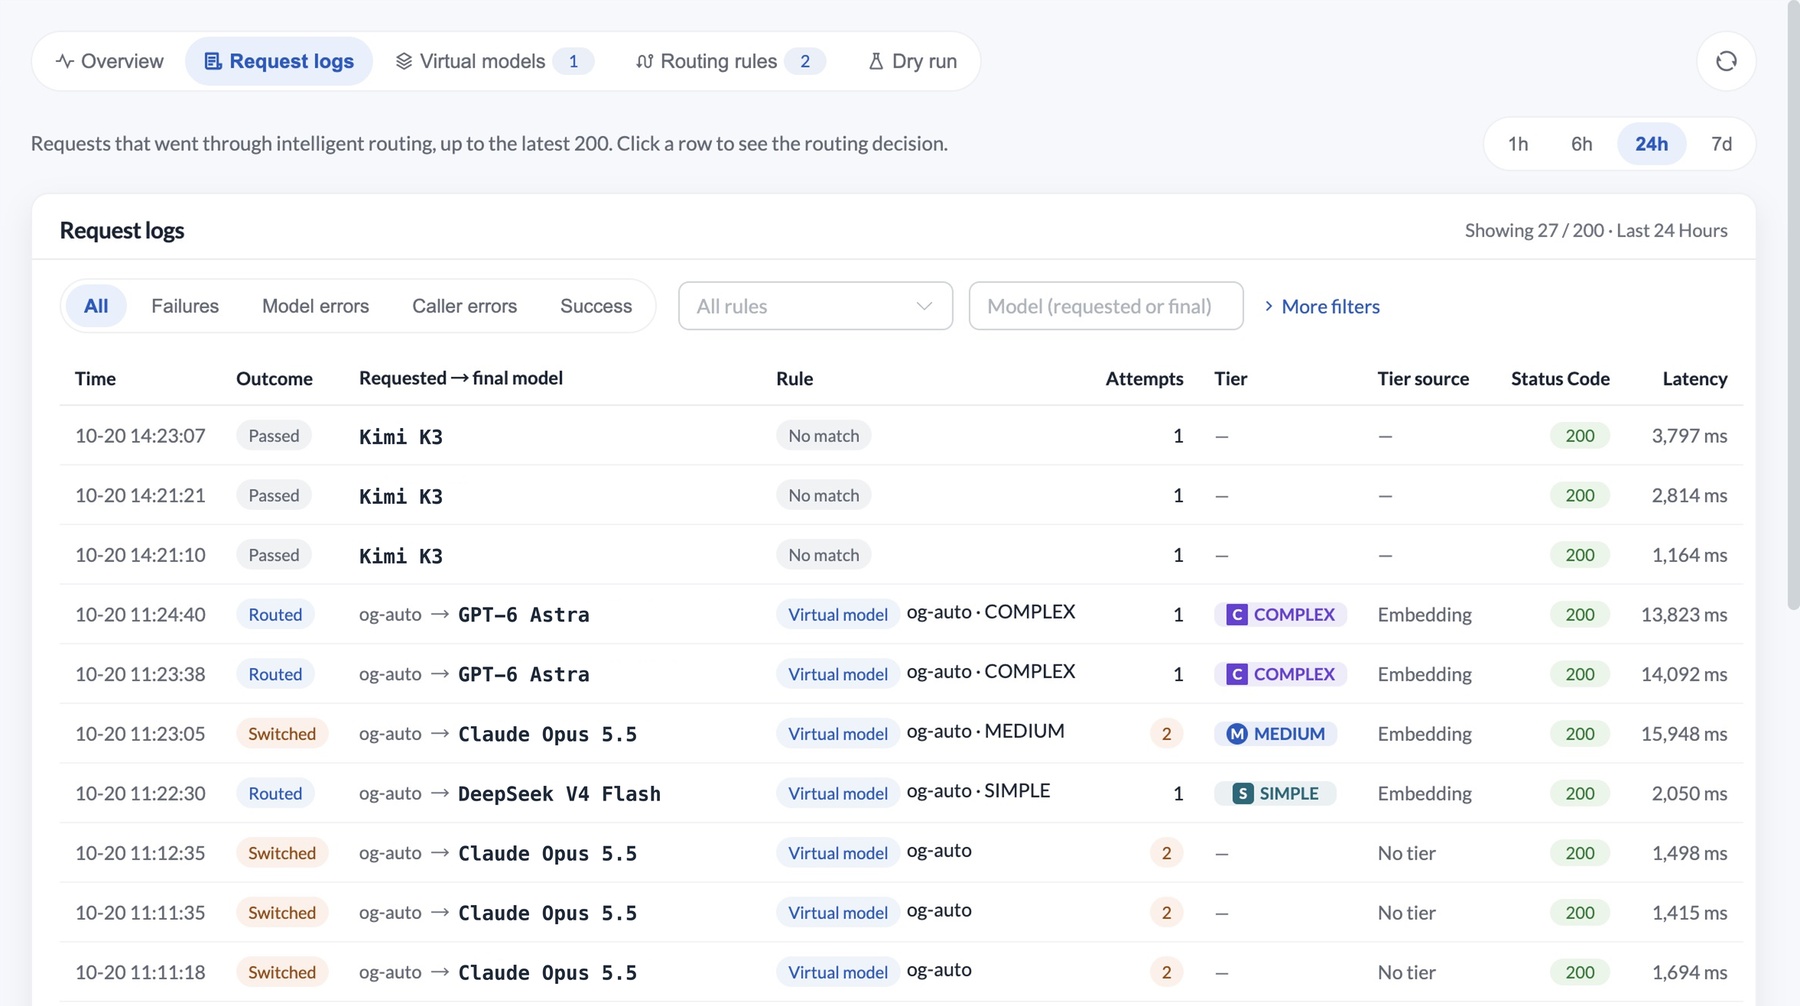
リクエストログの「モデル」はルーティング後のモデルです
リクエストログとダッシュボードに表示されるモデルは、ルーティング後に実際に呼び出されたモデルです。og-auto のような仮想モデル名は表示されません。元々指定されたモデルを確認するには、ルーティングモニターまたは og-route-requested-model レスポンスヘッダーを確認してください。
症状別のトラブルシューティング
| 症状 | 最初に確認すること |
|---|---|
og-route レスポンスヘッダーがない | プラグインが有効か、エンドポイントが対応範囲か、中継プロキシがレスポンスヘッダーを残しているか |
og-route: PASS でモデルが変わらない | モデル名がルールと完全に一致しているか(gpt-4o は gpt-4o-mini に一致しません)、ルールが有効か、保存に成功したか |
| 403 が返る | API Key のモデル許可リストに og-route-model のモデルが含まれているか |
| 400 料金未設定が返る | 対象モデルまたは候補モデルの価格が設定されているか |
FALLBACK が頻繁に発生する | 現在のグループでプライマリモデルに利用可能なプロバイダーがあるか。グループ設定の誤りは「常に切り替わる」形で現れます |
| 複雑度が想定と違う | ドライランで判定の根拠を確認します。分類モデルの指示や例文を調整するか、もう一方の方法に切り替えます |
og-route-tier が付かず、常に予備のルールになる | 分類モデルが設定され到達可能か、呼び出し側の API Key が有効か(既定では検証に通った API Key に対してのみ分類モデルを呼び出します。主な方法と予備の方法は、それぞれ管理者の設定に従って検証します) |
| ルールを変更したのに反映されない | 保存時にエラーが出ていないか。ルールに誤りがある場合、ゲートウェイは前回の有効なルールを使い続けます |
既知の制限
- インテリジェントルーティングが決めるのはモデルだけで、プロバイダーや API Key は選択しません。クォータやレート制限の使用率に基づく選択も行いません。
- 「最初のトークンまでのタイムアウト」による切り替えは行いません。出力を開始したストリーミングリクエストは別のモデルに切り替えません。
- 候補モデルの互換性は管理者が保証する必要があります。切り替え時はモデル名だけを変更し、候補モデルのコンテキスト長やツール呼び出しなどの能力に合わせてリクエストを調整しません。
- セッションの複雑度は、リクエストを処理するサービスの中に保存されます。サービスを複数デプロイしている場合は共有されず、同じセッションのリクエストが別のサービスに振り分けられると、判定をやり直します。
リクエストごとの制御
| リクエストヘッダー | 効果 |
|---|---|
hcd-og-route: off | このリクエストのルーティングをスキップし、元のモデルのまま転送します。既定では無効で、管理者が「呼び出し側によるルーティングのスキップを許可」を有効にする必要があります。ルーティングがコストやコンプライアンスのポリシーを担っている場合があるため、有効化の前に検討してください |
hcd-og-session-id | セッション ID。セッションの複雑度に使います |
hcd-og-tenant-id | テナント単位のルールの一致に使います。このヘッダーは呼び出し側が自由に設定できるため、振り分けの手段に限られ、セキュリティや課金の境界としては使えません |
他の機能との関係
- ガードレール:リクエストはルーティングより前にガードレールを通るため、ブロックされたリクエストでは複雑度判定のオーバーヘッドが発生せず、判定にはマスキング済みのテキストが使われます。
- セマンティックキャッシュ:ルーティングの後にセマンティックキャッシュを照会します。キャッシュは書き換え後のモデルで区別されるため、異なるモデルの回答が互いにヒットすることはありません。切り替えが発生したリクエストはキャッシュに書き込まれません。
- 呼び出しログ:ログはルーティングの外側で記録されるため、書き換えや切り替えが発生したリクエストについても、指定されたモデル、実際のモデル、一致したルール、試行回数、複雑度が記録されます。
よくある質問
呼び出し側は何を変更する必要がありますか?
リクエストのモデル名を、管理者から案内された仮想モデル名(例:og-auto)に変えるだけです。エンドポイント、リクエスト形式、SDK はそのままです。既存のモデルに対する置き換えやフェイルオーバーのルールは、呼び出し側からは完全に透過的です。
og-auto が利用可能なモデルの一覧に表示されないのはなぜですか?
仮想モデルはゲートウェイのルーティングルールの中にだけ存在し、どのプロバイダーにも対応しないため、利用可能なモデルには表示されません。リクエストで直接使用できます。利用できる仮想モデル名は管理者に確認してください。
インテリジェントルーティングでどのくらい遅延が増えますか?
ルールの照合はゲートウェイ内で完結するため、通常オーバーヘッドは無視できる程度です。複雑度が必要な場合、ローカル採点では待ち時間はほとんど増えません。その他の方法では判定ごとに分類モデルの呼び出しが 1 回増えます(ローカル優先では判断がつかない場合のみ)。所要時間は分類サービスの配置場所とネットワークによって異なり、社内ネットワークに Embedding モデルを置いたテストでは数十〜100 ミリ秒程度でした。呼び出しの前に、呼び出し側の認証情報の確認が行われる場合もあります(結果はキャッシュされます)。タイムアウト時はそのリクエストに複雑度が付かず、後続のルールで処理されます。切り替えが発生した場合、合計時間には失敗した試行の時間も含まれます。
複雑度の判定で内容はどこに送られますか?
テキストが送られるのは、複雑度が必要で、かつ分類モデルを呼び出す場合だけです。ローカル採点では何も送られず、ローカル優先では判断がつかないリクエストだけが送られます。判定に使うユーザーメッセージのテキスト(既定は直近の 1 件で、管理者は message_window で直近の複数件に広げられます)が、管理者の設定した分類モデル(プラットフォーム自身が運用するモデルも可)に送られます。システムプロンプト、アシスタントの返答、ツールの返却結果は送られません。分類の呼び出し費用はプラットフォームが負担し、呼び出し側のクォータには計上されません。
同じ質問なのに、A のモデルを使うときと B のモデルを使うときがあるのはなぜですか?
原因は 3 つ考えられます。ルールで割合による振り分けが設定されている、複雑度の判定が言い回しの違いに影響される、またはプライマリモデルの失敗後に候補モデルへ切り替わった、のいずれかです。レスポンスヘッダーの og-route-rule、og-route-tier、og-route-attempts で区別できます。
その他の早見表
| 疑問 | 結論 |
|---|---|
| ルールを変更したらゲートウェイの再起動が必要ですか | 不要です。保存するとすぐに反映されます |
| ルールの誤りでリクエストが失敗しますか | いいえ。ゲートウェイは前回の有効なルールを使い続け、条件にエラーのある個別のルールはスキップされるだけです |
| モデル名は大文字と小文字を区別しますか | ルールの照合では区別しませんが、文字列全体が一致する必要があります |
| 一部のテナントだけに適用できますか | 可能ですが、テナントヘッダーは呼び出し側が偽装できるため、振り分けの手段に限られます。リクエストごとの制御を参照してください |
| フィールドと高度な設定 | インテリジェントルーティング技術リファレンス(現在は中国語のみ)を参照してください |