智能路由
概述
智能路由(也称模型路由)在请求发往上游之前决定这次请求最终使用哪个模型。调用方照常写模型名,网关按管理员配置的规则改写模型,必要时在主模型失败后自动换用候选模型。
典型用途:
| 场景 | 说明 |
|---|---|
| 自动分档 | 调用方统一写一个虚拟模型名(如 og-auto),网关按请求复杂度选择简单、中等、复杂三档模型:简单问题用便宜的模型,复杂任务用更强的模型 |
| 模型替换与灰度 | 把某个模型的请求全部或按比例切到另一个模型,调用方不需要改代码 |
| 故障兜底 | 某个模型最终调用失败时,按顺序切换到候选模型,减少因单个模型不可用导致的失败 |
| 条件路由 | 请求满足条件时切到指定模型,例如超长输入用长上下文模型、带图片用视觉模型、带工具调用用擅长函数调用的模型、指定租户或客户端(如 Claude Code)使用专门的模型 |
智能路由根据请求内容(如任务复杂度)选择用哪个模型;供应商路由则按延迟、价格、可用性等运行指标,为同一个模型选择供应商,属于流量管理。两者是两层不同的能力:
| 智能路由(本页) | 供应商路由 | |
|---|---|---|
| 决定什么 | 用哪个模型 | 同一个模型用哪个供应商 |
| 失败时 | 换成另一个模型重新请求 | 在同一模型的供应商之间重试 |
| 计费 | 按改写后的模型计费 | 不改变计费模型 |
| 执行顺序 | 先 | 后:智能路由选好模型后,每次请求都会再经过供应商路由 |
工作方式
| 概念 | 说明 |
|---|---|
| 规则 | 一组匹配条件加上处理方式。规则按优先级依次匹配,第一条命中的规则生效 |
| 目标模型 | 命中后改用的模型。可以配置多个并设置权重,按比例随机选择 |
| 候选模型 | 主模型最终失败时依次尝试的模型 |
| 虚拟模型 | 只在网关里存在的模型名(如 og-auto),本身不需要在供应商处存在或定价 |
| 复杂度档位 | SIMPLE(简单)、MEDIUM(中等)、COMPLEX(复杂),由网关根据请求内容判断 |
没有任何规则命中的请求原样转发,模型不变。规则本身出错(例如条件写法有误)时只跳过这条规则,不会拦截请求。
使用前提
- 管理员已在目标 Gate 实例上启用智能路由插件,并配置了路由规则。
- 规则中出现的每个目标模型和候选模型,都已在供应商与模型中接入并定价,且调用方所在分组有可用的供应商。
- 调用方使用的 API Key 如果开了模型白名单,白名单里要包含这些目标模型和候选模型,见计费与权限。
支持的接口
| 接口类型 | 路径 | 模型从哪里取 |
|---|---|---|
| OpenAI 格式 | POST /v1/chat/completions | 请求体 model,含流式 |
| OpenAI Responses 格式 | POST /v1/responses | 请求体 model,含流式 |
| Anthropic 格式 | POST /v1/messages | 请求体 model,含流式 |
| 旧版补全 | POST /v1/completions | 请求体 model,含流式 |
| Gemini 原生格式 | POST /v1beta/models/{model}:generateContent、:streamGenerateContent | URL 中的模型,请求体里的 model 不参与 |
管理员配置
管理界面为预览版
本节介绍的场景配置、试运行和路由监控界面目前是预览版,可从 OneGateway 控制台的「高级插件 → 智能路由」进入。管理员也可以直接编辑 Gate 的规则定义文件,或调用 Gate 的规则管理接口完成配置和试运行。
常用用法可以按场景配置,填写模型即可。下表的效果是按场景配置时生成的规则;直接编写规则文件时,行为以所写规则为准:
| 场景 | 需要填写 | 效果 |
|---|---|---|
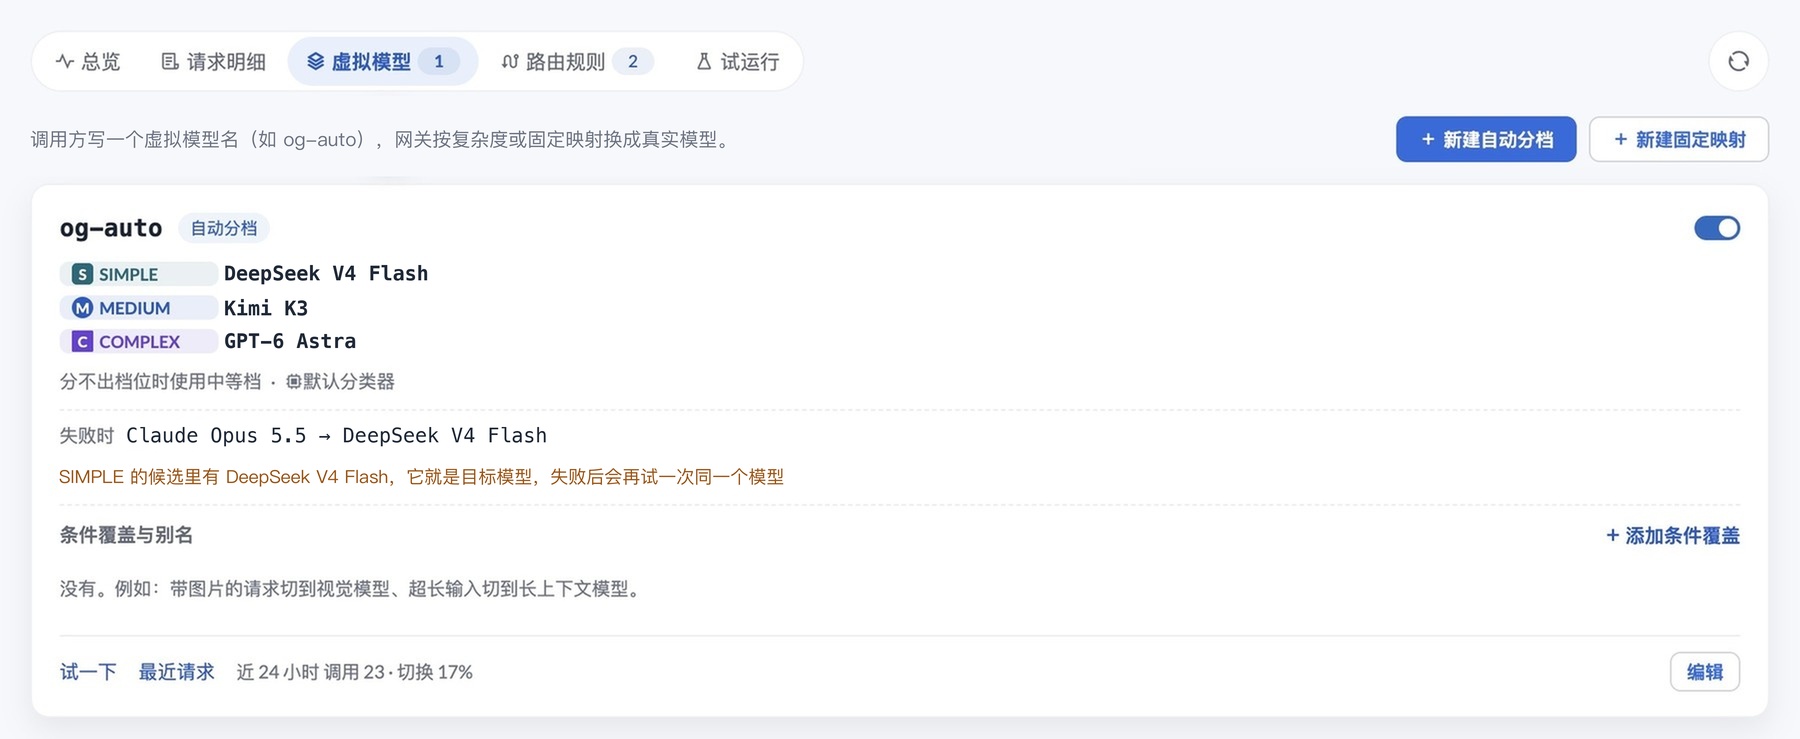
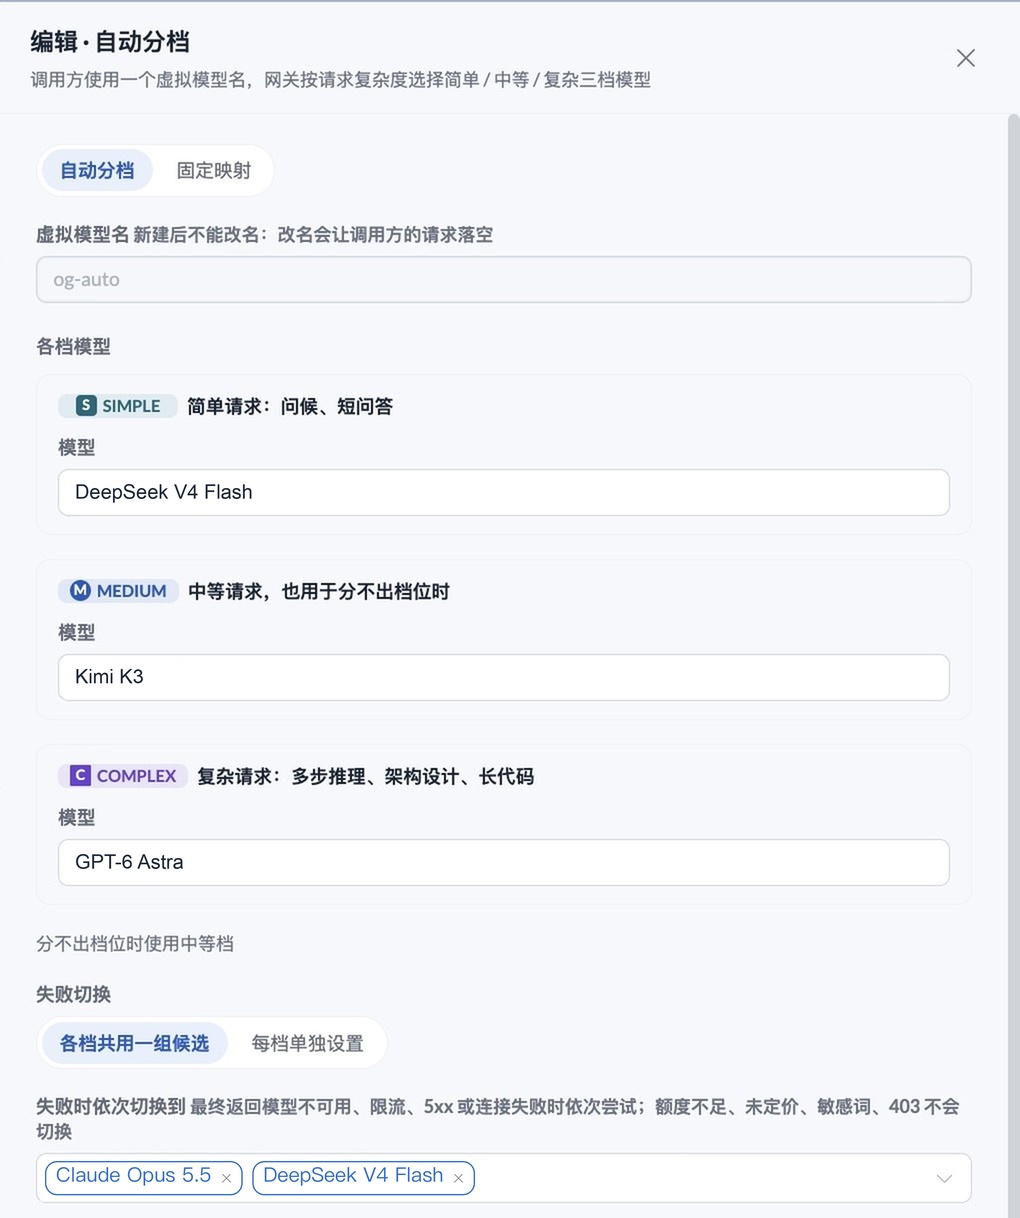
| 虚拟模型 · 按复杂度分档 | 虚拟模型名,以及简单、中等、复杂三档各用哪个模型 | 除三档规则外,还会生成一条兜底规则:复杂度判断不出来时(例如请求只有图片)使用中等档模型 |
| 虚拟模型 · 固定映射 | 虚拟模型名,以及换成哪个模型;可以填多个模型并设置比例 | 调用方写虚拟模型名(如 og-coding),网关固定换成指定的真实模型 |
| 替换与分流 | 原模型,以及替换成哪个模型;可以填多个模型并设置比例 | 一个模型即全部替换;多个模型按比例分配,用于灰度或负载均衡,可以把原模型也放进来保留一部分流量 |
| 故障兜底 | 主模型,以及按顺序排列的候选模型 | 不改模型,只在失败时切换 |
| 模型别名 | 若干别名,以及归一到哪个模型 | 别名先换成目标模型,再按目标模型上的其他场景继续处理 |
| 条件路由 | 作用于哪些模型(可用通配符,留空表示所有模型)、条件、切到哪个模型 | 条件可组合:长上下文(估算 token 数达到阈值)、含图片、带工具、租户、请求头(如按 user-agent 识别客户端)、推理强度、协议、流式、复杂度档位 |
除故障兜底外,每个场景都可以可选地附带失败时的候选模型;自动分档的三档可以共用一组候选,也可以各自设置。需要时还能为单个场景自定义切换条件(哪些状态码、额外哪些错误码会切换,最多尝试几次),其余场景沿用全局设置,见失败时自动切换。
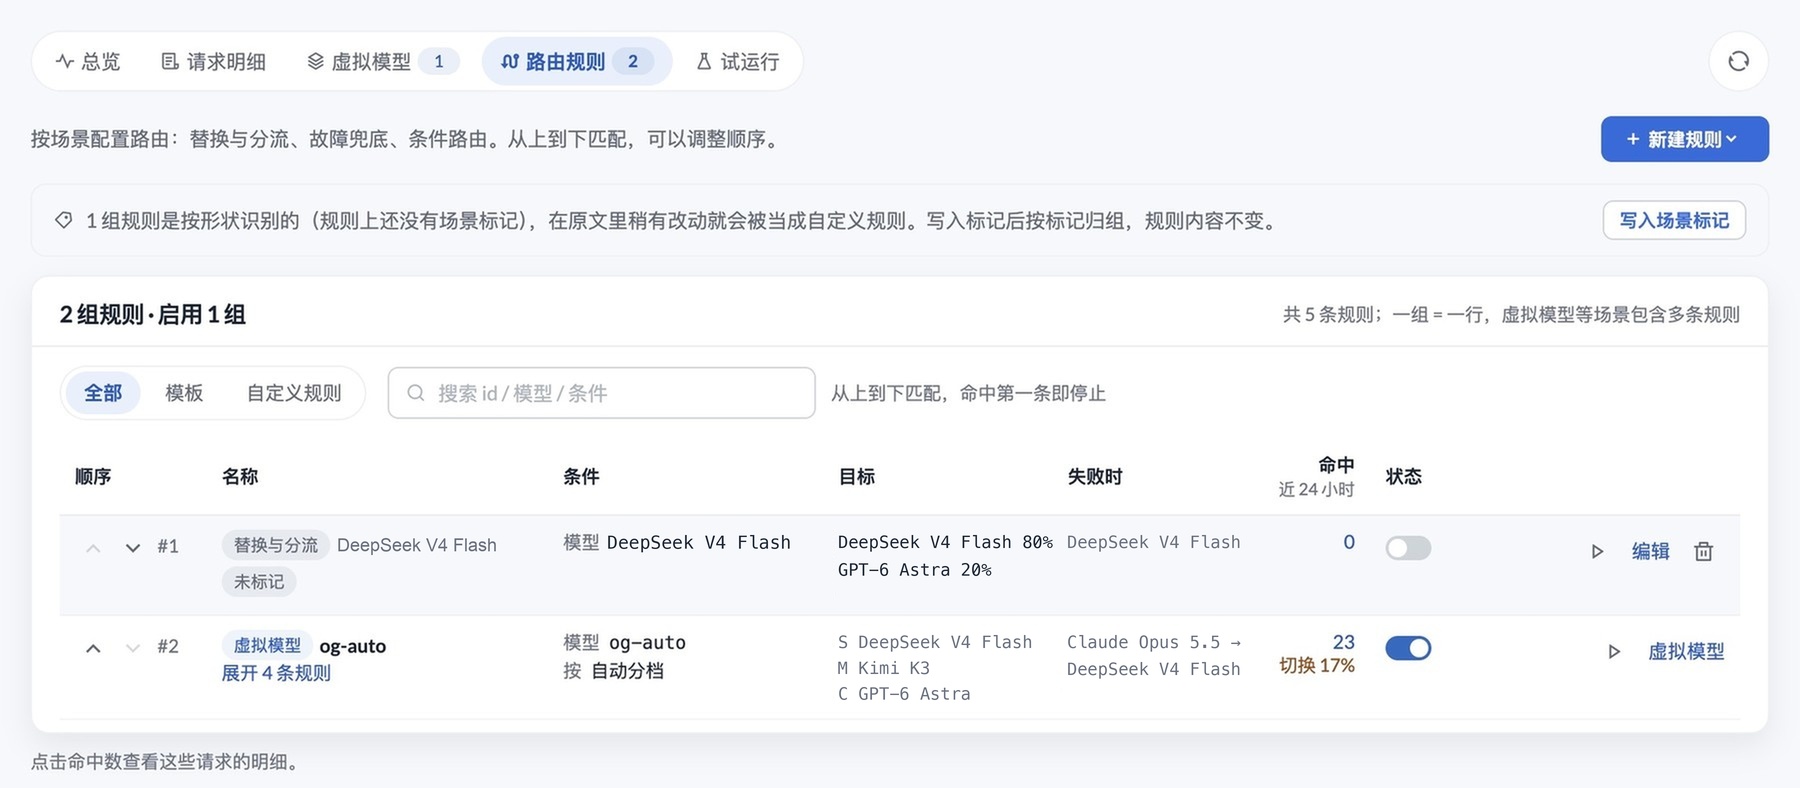
虚拟模型在单独的「虚拟模型」页管理,卡片上同时列出作用于它的条件路由(例如带图片走视觉模型),可以直接添加。其余场景与手写规则在「路由规则」页合成一张列表,按匹配顺序排列,第一个命中的生效:条件路由默认放在作用于同一模型的其他规则之前;使用行首的上移、下移按钮即可调整顺序,保存时自动分配优先级。如果某个场景排在一个会接下全部同类请求的场景后面,永远不会命中,界面会标出"不会命中"。
每个场景由一条或多条规则组成,规则上带有场景标记(scenario,只供界面归组,不影响路由结果)。在规则原文里手动改过、与场景模板对不上的规则会显示为自定义规则,只能在原文中修改。
保存前可以先用一条样例请求试运行,确认会命中哪条规则、改成哪个模型、判成哪个档位。试运行不会把请求转发给目标模型,也不会产生这次业务模型的生成费用;但启用 LLM 或 Embedding 分类时,仍会调用配置的分类服务,可能产生平台侧费用,样例文本也会发送给该服务。
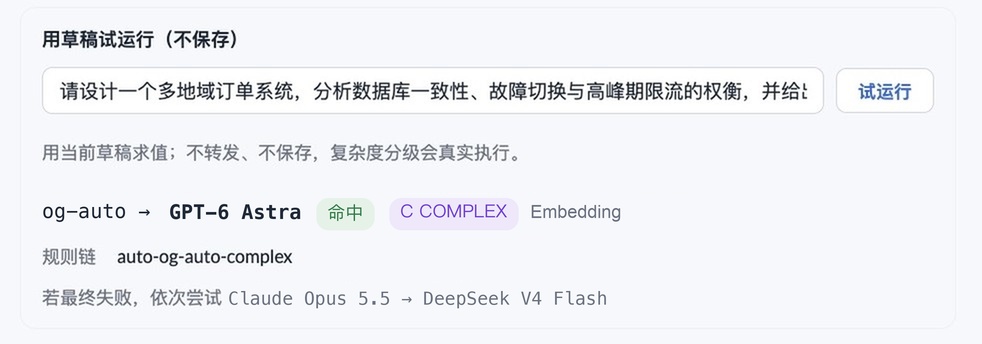
规则保存后立即生效,不需要重启网关。需要更复杂的条件时(按请求头、租户、协议、输入长度等组合判断,或链式规则),在规则原文中编写,字段与示例见技术参考。
日常配置与平台配置
管理界面把配置分成两级,分开摆放:
| 级别 | 适合谁 | 包括 |
|---|---|---|
| 日常配置 | 组织(公司)管理员:了解 AI Token、对平台功能有一定动手能力 | 虚拟模型、替换与分流、故障兜底;用长上下文、含图片、带工具、客户端组合的条件路由;场景的启停、排序和候选模型;从已有分类器里选一个;试运行 |
| 平台配置 | OneGateway 平台管理员 | 分类器、全局切换策略、可用模型范围、插件开关与运行参数;场景的切换条件;模型别名;按租户、推理强度等条件分流;自定义规则与原文编辑;告警阈值 |
管理界面右上角的视角按钮可以在"组织管理员视角"和"平台管理员视角"之间切换:组织管理员视角只显示日常配置;平台管理员视角显示全部内容,平台配置在菜单的「平台配置」分组里,或在日常页面中收进带「平台配置」标签的折叠区块。平台配置填错会影响全部请求,建议由平台管理员维护。
告警提醒
页面顶部会在以下情况出现提醒,阈值在平台设置里调整:
- 某个场景最近 1 小时因限流、上游故障失败的比例过高,可以考虑添加候选模型;
- 切换到候选模型的请求比例过高,主模型可能不稳定;
- 需要复杂度档位的请求里拿不到档位的比例过高,需要平台管理员检查分类器。
令牌无效、额度不足、模型未定价这类调用方问题换模型也解决不了,不计入失败率,在总览里单独显示。
复杂度怎么判断
复杂度由平台配置的分类器判断,有以下几种方式:
| 方式 | 做法 |
|---|---|
| 本地打分 | 直接按问题的长度、代码词、推理词、技术词、寒暄或简单问句等信号打分,按分数定档;不调用任何模型,几乎不增加耗时,也不产生费用 |
| 本地优先 | 先本地打分;寒暄、短问答这类有明确信号的简单问题直接定档,拿不准的才交给 LLM 分类 |
| LLM 分类 | 把用户的问题交给一个平台提供的小模型,由它判断属于哪一档 |
| Embedding 样例匹配 | 与预置的三档样例句比相似度,最接近哪一档就归入哪一档 |
LLM 分类和 Embedding 样例匹配使用平台自己的模型和凭据,不使用调用方的 API Key 和模型;每次判断会额外调用一次分类模型。本地优先只在拿不准时才调用。管理员可以把另一种方式设为兜底,主方式失败时改用它;用本地打分兜底时一定能得到档位。
本地打分只看措辞,判断比模型粗:实测单用时只有一半左右判对,更推荐用“本地优先”,在省掉约四成分类调用的同时保持接近 LLM 的准确率。它只是路由提示,调用方可以通过措辞影响档位。
管理员也可以配置两个独立的 LLM 分类模型:主模型成功时只调用主模型;主模型超时、失败、返回无效档位或并发已满时才调用备用模型。下一次需要分级的请求仍先尝试主模型,恢复后自动用回主模型。两个模型都失败时才拿不到档位;备用档位只用于当前请求,不写入会话。主备可以使用不同服务商的端点和密钥,减少共同故障。
分类在业务模型调用之前执行,因此等待时间会直接增加流式首字节延迟和非流式响应时间。每次新的分类都会优先尝试主模型;如果主模型持续超时,每次请求都会先等待主超时再使用备用。管理员应按实测延迟设置较短的主超时,并把主备调用及凭据校验的最坏等待计入整体延迟预算。
没有配置分类器时不做复杂度判断
管理员没有配置分类器,或分类模型暂时不可用、调用超时且没有兜底时,这次请求拿不到档位,按档位分流的规则都不会命中,请求交给后面的规则处理。自动分档场景会生成一条兜底规则,这种情况下使用中等档模型。
默认只看用户本人写的最近一条消息,管理员可以通过 message_window 扩大到最近多条。系统提示词、助手回复、工具返回结果都不参与判断,Claude Code 等工具自动附加的提示标签也会被去掉。
不同虚拟模型可以用不同的分类器:管理员可以另建“命名分类器”(例如闲聊入口用本地打分,编码入口用 LLM),再让某个虚拟模型选用它。没有指定的虚拟模型用默认分类器。同一会话在不同虚拟模型上的档位各自记录、互不影响。
各分类方式的差异、参数与准确率见复杂度分级。
什么时候会做复杂度判断
规则按优先级依次匹配,第一次遇到需要复杂度的条件时才做判断,同一个分类器每个请求最多判断一次;链式规则先后用到不同的命名分类器时,会各判断一次,开销叠加。如果在此之前已经命中一条与复杂度无关的规则,就不会判断,也没有额外开销;但如果判断已经发生,即使最终命中的是一条与复杂度无关的规则,判断的开销也已经产生。
会话档位
开启后,同一会话里的档位只升不降:长对话前面已经判为复杂,后面的简短追问也继续使用复杂档模型,避免在模型之间来回切换导致供应商的上下文缓存失效。只有请求成功返回、且档位来自管理员配置的分类器时才会记入会话;分类器失败时临时使用的兜底判断只对这一次请求生效。会话空闲超过有效期,或管理员更换了主要的判断方式(换分类模型、改提示词或样例等)后,会重新开始判断;只增删或调整兜底方式不影响已有会话。会话按 hcd-og-session-id 请求头识别,Claude Code 自带的会话头也会被识别;不同 API Key 即使使用相同会话 ID 也互不影响。
快速验证
确认已配置一个自动分档场景(以虚拟模型 og-auto 为例)。将地址、API Key 替换为实际值,发送一条简单请求:
curl -sS -i 'https://your-gateway.example.com/v1/chat/completions' \
  -H 'Authorization: Bearer <ONEGATEWAY_API_KEY>' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "og-auto",
    "messages": [{"role": "user", "content": "你好,今天天气怎么样?"}]
  }'
然后保持其他部分不变,替换 content,依次验证:
| 验证项 | content | 预期响应头 |
|---|---|---|
| 简单请求 | 你好,今天天气怎么样? | og-route: ROUTED,og-route-tier: SIMPLE,og-route-model 为简单档模型 |
| 中等请求 | 帮我分析一下这段日志里的报错原因 | og-route-tier: MEDIUM,og-route-model 为中等档模型 |
| 复杂请求 | 一段要求设计系统架构并分析权衡的长文本 | og-route-tier: COMPLEX,og-route-model 为复杂档模型 |
流式请求("stream": true)同样会返回这些响应头,在第一段内容之前即可看到。判断路由选了哪个模型,以 og-route-model 为准。响应体里的 model 是供应商回报的模型名,供应商对模型做了映射或使用带版本号的名称时,可能与 og-route-model 不同。
计费与权限
按路由后的模型计费:请求 og-auto 被改成哪个模型(即 og-route-model),就按这个模型在平台上的价格计费,供应商侧看到和记录的也是改写后的模型。虚拟模型名本身不需要定价。具体费用以日志中的计费明细为准。
开了模型白名单的 API Key
供应商侧按改写后的模型校验 API Key 的模型白名单。只把 og-auto 加进白名单没有用:规则里可能用到的每个目标模型和候选模型都要加进去,否则请求返回 403,而且 403 不会触发切换。
切换到候选模型时,失败的那次尝试不扣费,只按最终成功的那次计费。
失败时自动切换
命中的规则配置了候选模型时,主模型最终失败(供应商路由已经重试过,仍然失败)后,网关按顺序尝试候选模型。
| 主模型返回 | 是否切换 | 原因 |
|---|---|---|
| 503 无可用供应商、429 限流、500 / 502 / 503、529 供应商过载、连接失败 | 切换 | 该模型暂时不可用,换模型可能成功 |
| 504 / 524 超时 | 默认不切换 | 再换模型会让等待时间成倍增加;管理员可以改为切换 |
| 400 未定价、403 无权访问、额度不足 | 不切换 | 换模型解决不了,还可能借切换绕过权限 |
| 敏感词拦截 | 不切换 | 同样的内容在其他模型上也会被拒绝 |
- 默认最多尝试 3 次(含第一次)。
- 以上是全局默认。单个场景可以自定义切换条件,例如长上下文场景把 504 也算作可切换,或在上下文超长的错误码上切换;只影响这个场景,额度不足、未定价、敏感词等排除项始终不切换。
- 流式请求只在开始输出之前切换;已经开始输出内容后上游中断,不会再换模型。
- 候选模型也全部失败时,返回最后一次尝试的错误。
- 发生过切换的请求不会写入语义缓存。
观察效果与排障
先看响应头:
| 响应头 | 含义 |
|---|---|
og-route | PASS 没有规则命中;ROUTED 命中规则;FALLBACK 发生了切换(结果看状态码);BYPASS 调用方跳过了路由;ERROR 路由自身出错,请求按原模型转发 |
og-route-rule | 命中的规则标识(只显示标识,不显示条件) |
og-route-model | 路由后发给供应商的模型(发生切换时是最后一次尝试的模型),也是计费所用的模型 |
og-route-requested-model | 调用方原本请求的模型,只在模型被改写时出现 |
og-route-attempts | 上游尝试次数(含第一次),大于 1 表示发生了切换 |
og-route-tier | 复杂度档位,只在做过复杂度判断时出现 |
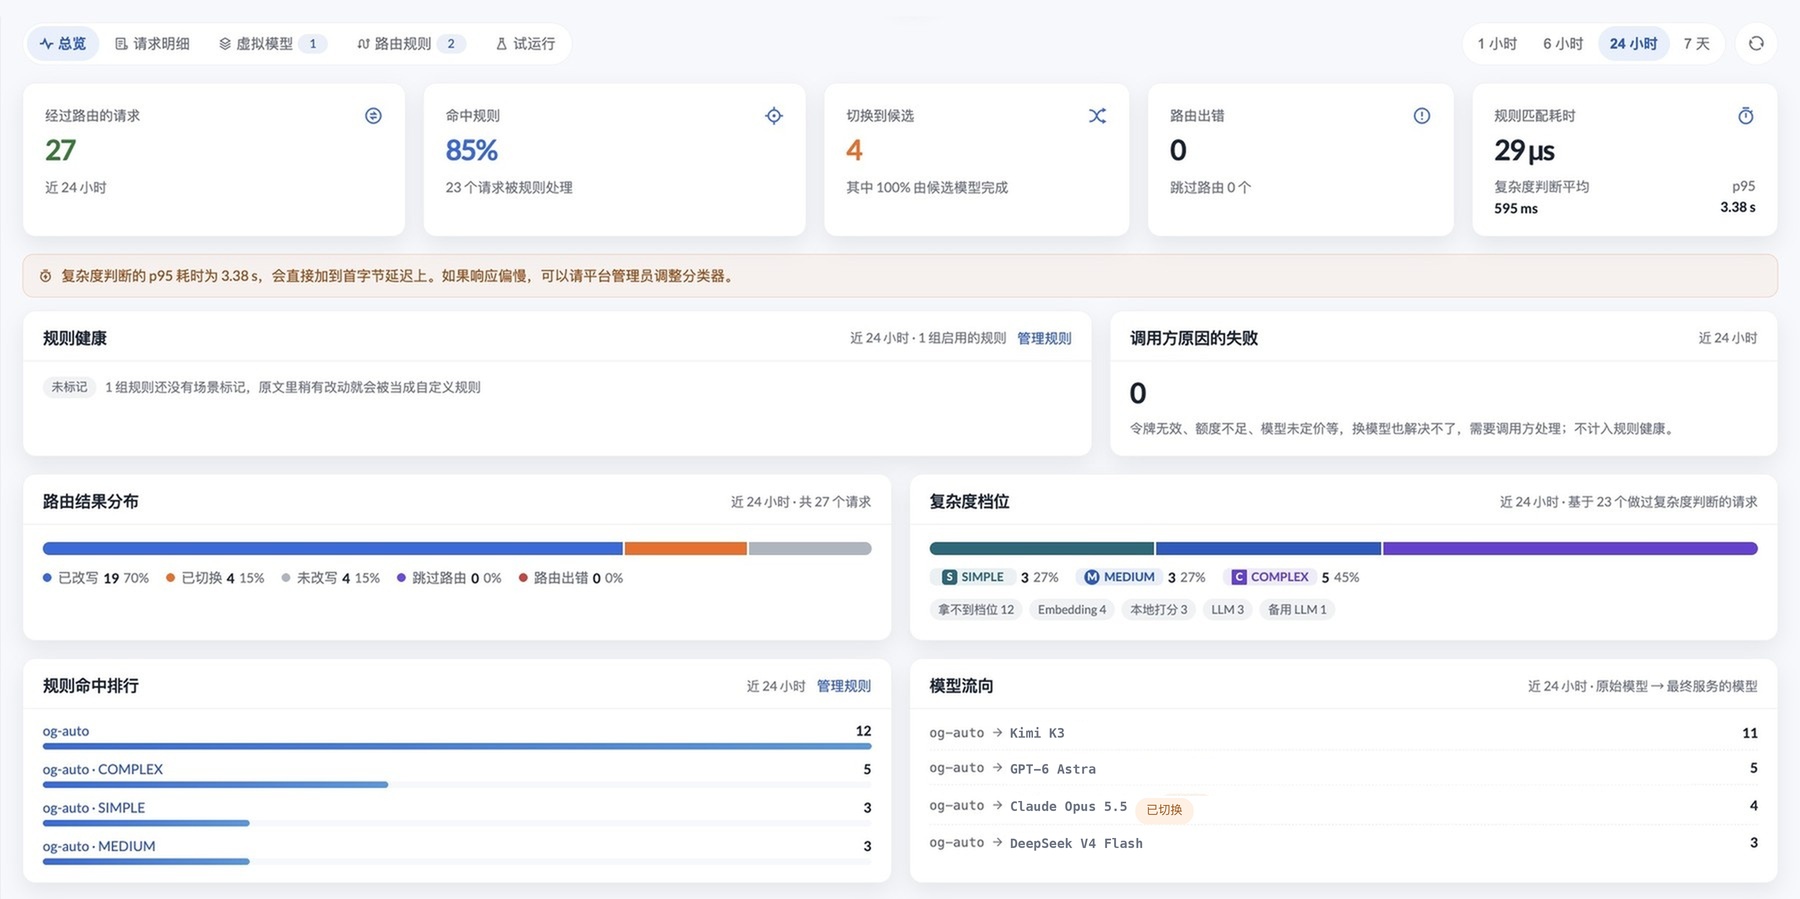
启用日志存储后,管理员可以在路由监控中按时间窗口查看路由结果分布、复杂度档位分布、"请求模型 → 实际模型"的流向,并下钻到每个请求。
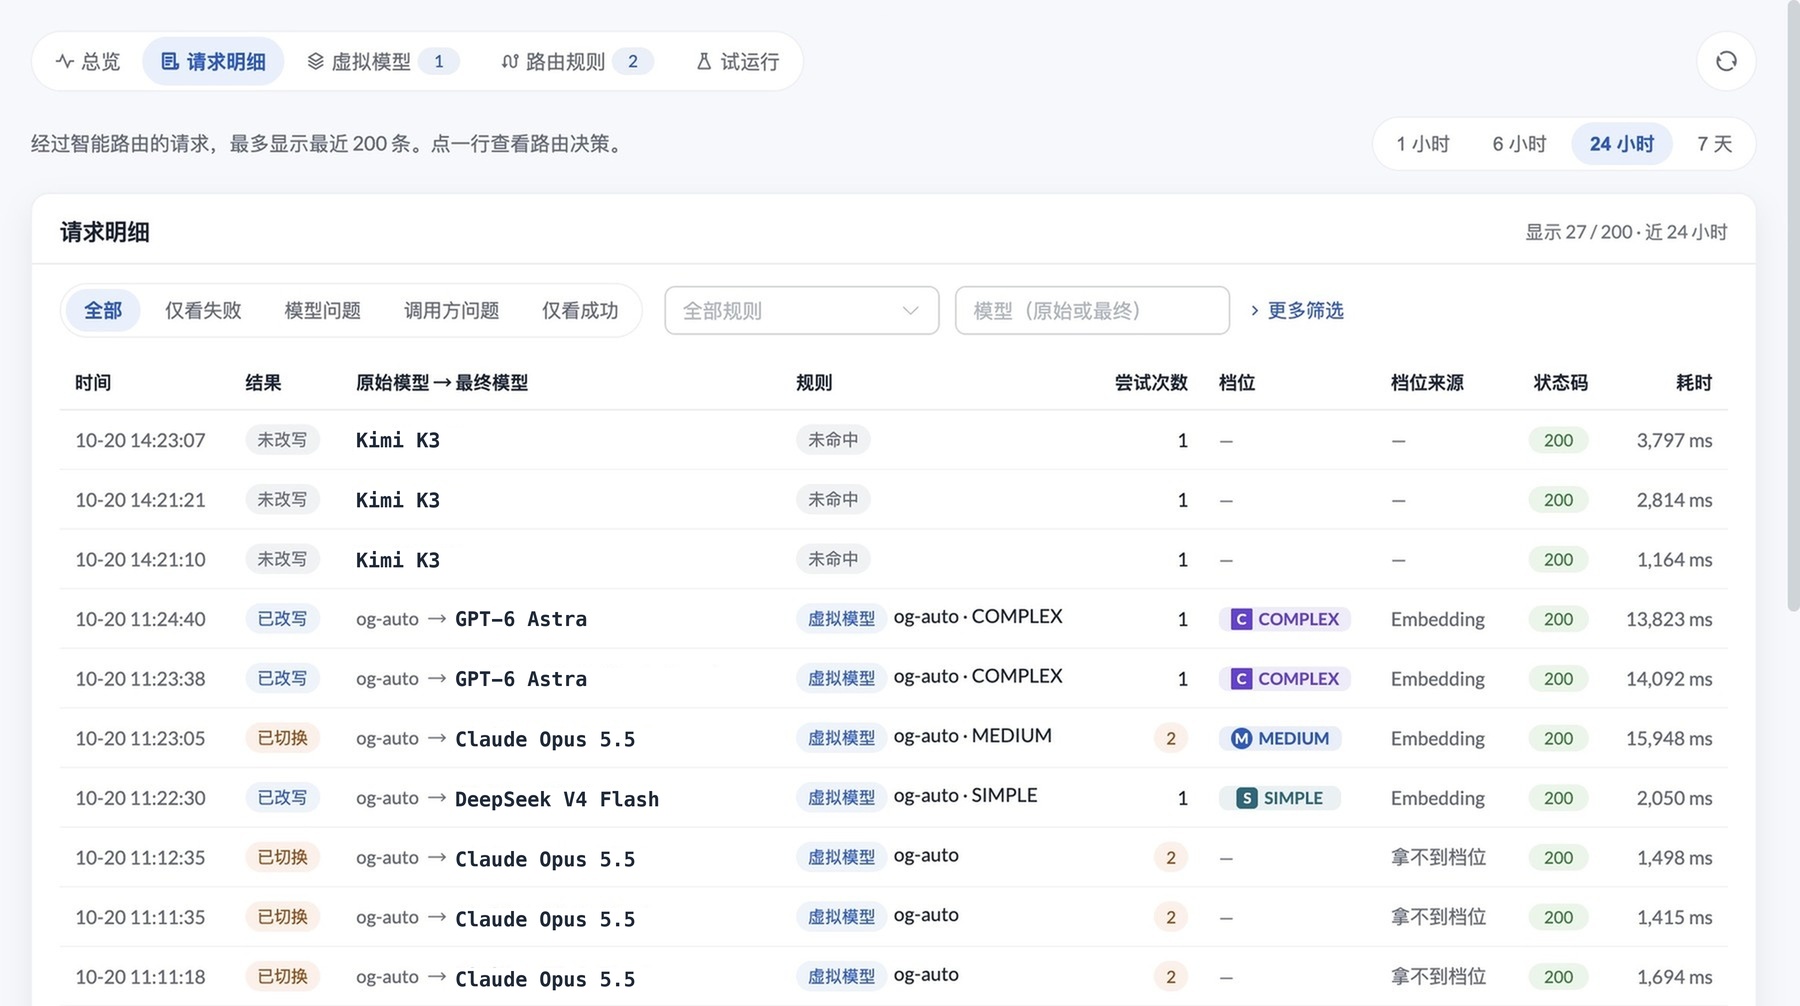
使用日志里的「模型」是路由后的模型
日志和看板中的模型都是路由后实际调用的模型,不会出现 og-auto 这类虚拟模型名。要查调用方原本请求的模型,看路由监控或响应头 og-route-requested-model。
按现象排查
| 现象 | 优先检查 |
|---|---|
没有 og-route 响应头 | 智能路由插件是否启用、接口是否在支持范围内、中间代理是否保留了响应头 |
og-route: PASS,模型没变 | 模型名是否与规则完全一致(gpt-4o 不会匹配 gpt-4o-mini)、规则是否启用、规则是否保存成功 |
| 返回 403 | API Key 的模型白名单是否包含 og-route-model 显示的模型 |
| 返回 400 未定价 | 目标模型或候选模型是否已定价 |
频繁出现 FALLBACK | 主模型在当前分组是否有可用供应商;分组配置错误时会表现为"一直切换" |
| 档位和预期不一致 | 用试运行看判断依据;可调整分类模型的指引或样例句,或换用另一种分类方式 |
没有 og-route-tier,请求总是走兜底规则 | 是否配置了分类模型、分类模型是否可达;调用方的 API Key 是否有效(默认只为通过校验的 API Key 调用分类模型,主方式与兜底方式各自按管理员的设置校验) |
| 规则改了但没生效 | 保存时是否报错;规则写错时网关会继续使用上一份可用的规则 |
已知边界
- 智能路由只决定用哪个模型,不选择供应商或 API Key,也不按额度或限流使用率选择模型。
- 不做"首个字超时"切换:已经开始输出的流式请求不会再换模型。
- 候选模型要由管理员保证兼容:切换时只换模型名,不会根据候选模型的上下文长度、工具调用等能力调整请求。
- 会话档位保存在处理请求的服务中。部署了多套服务时彼此不共享,同一会话的请求被分到另一套服务时会重新判断。
按请求控制
| 请求头 | 作用 |
|---|---|
hcd-og-route: off | 本次请求跳过路由,按原模型转发。默认不生效,需要管理员开启"允许调用方跳过路由";路由可能承载成本或合规策略,开启前请评估 |
hcd-og-session-id | 会话标识,用于会话档位 |
hcd-og-tenant-id | 参与按租户匹配的规则。这个头调用方可以随意设置,只能作为分流手段,不能当作安全或计费边界 |
与其他能力的关系
- 安全护栏:请求先过安全护栏再做路由,被拦截的请求不会产生复杂度判断的开销,复杂度判断看到的也是已经脱敏的文本。
- 语义缓存:先路由再查语义缓存,缓存按改写后的模型区分,不同模型的回答不会互相命中;发生过切换的请求不写入缓存。
- 调用日志:日志在路由的外层,被改写和发生切换的请求都会记录请求模型、实际模型、命中规则、尝试次数和复杂度档位。
常见问题
调用方需要改什么?
只需要把请求里的模型名改成管理员提供的虚拟模型名(如 og-auto)。接口、请求格式和 SDK 都不用变。对已有模型配置的替换或兜底规则,调用方完全无感知。
og-auto 为什么在可用模型列表里看不到?
虚拟模型只在网关的路由规则里存在,不对应任何供应商,所以不会出现在可用模型中。可以直接在请求里使用,具体可用的虚拟模型名请向管理员确认。
智能路由会增加多少延迟?
规则匹配在网关本地完成,开销通常可以忽略。用到复杂度档位时,本地打分几乎没有额外耗时;其他方式每次判断会多一次分类模型调用(本地优先只在拿不准时调用),耗时取决于分类服务的部署位置和网络(在内网部署 Embedding 模型的测试中约为几十到一百毫秒);调用前还可能先对调用方凭据做一次校验(结果会缓存)。超时后这次请求不分档,交给后面的规则处理。发生切换时,总耗时包含失败那次尝试的时间。
复杂度判断会把我的内容发给谁?
只有用到复杂度档位、且需要调用分类模型时才会发送;本地打分不发送任何内容,本地优先只发送拿不准的请求。参与判断的用户消息文本(默认最近一条,管理员可通过 message_window 扩大到最近多条)会发送到管理员配置的分类模型(可以是平台自己部署的模型)。系统提示词、助手回复和工具返回结果不会发送。分类调用的费用由平台承担,不计入调用方额度。
为什么同一个问题有时用 A 模型、有时用 B 模型?
可能有三个原因:规则配置了按比例灰度;复杂度判断对措辞变化敏感;或者主模型失败后切换到了候选模型。看响应头 og-route-rule、og-route-tier、og-route-attempts 即可区分。
其他速查
| 疑问 | 结论 |
|---|---|
| 改了规则要重启网关吗 | 不需要,保存后立即生效 |
| 规则写错会导致请求失败吗 | 不会,网关继续使用上一份可用的规则;单条规则条件出错只跳过这条规则 |
| 模型名区分大小写吗 | 规则匹配不区分大小写,但必须整串一致 |
| 能只对部分租户启用吗 | 可以,但租户头可以被调用方伪造,只能作为分流手段,见按请求控制 |
| 字段与高级配置 | 见智能路由技术参考 |