语义缓存
概述
语义缓存让相同或语义相近的请求复用已有回答,减少重复的模型生成调用。例如,“商品不满意,怎么申请退款?”与“购买后想退款,需要怎么操作?”可能复用同一回答。
适合常见问题、产品咨询等答案稳定的业务。实时信息、个人状态和需要每次生成不同内容的任务,应谨慎启用。语义命中会直接返回旧回答,不会按新问题改写。
这与供应商的提示词缓存(Prompt Caching)不同:提示词缓存通常仍需执行模型生成,统计和计费口径也不同。
使用前提与模式选择
管理员需先启用缓存并配置可用存储。请求还需具备有效的单一 API 凭据、可解析的缓存键,且消息条数不超过历史阈值(默认 3 条,不是 3 轮)。
| 模式 | 工作方式 | 需要准备 |
|---|---|---|
| 仅精确匹配(Direct) | 复用归一化后相同请求的回答 | 缓存存储 |
| 精确与语义匹配(Semantic) | 先精确匹配,未命中再按语义相似度查找 | 缓存存储、Embedding 服务及匹配的向量维度 |
Embedding 将文本转为向量,用于比较语义。语义查找会增加调用开销;如果仍未命中,还需继续请求上游,因此低命中率业务不一定更快或更省。
支持的接口
| 接口类型 | 路径 | 支持范围 |
|---|---|---|
| OpenAI 格式 | POST /v1/chat/completions | 非流式与流式 |
| Anthropic 格式 | POST /v1/messages | 非流式与流式 |
| OpenAI Responses 格式 | POST /v1/responses | 无状态请求,含流式 |
Responses 使用 background: true、conversation 或非空 previous_response_id 时跳过缓存;/v1/responses/compact 不参与缓存。
快速验证
确认缓存已启用,将地址、API Key 和模型替换为实际值:
curl -i 'https://your-gateway.example.com/v1/chat/completions' \
  -H 'Authorization: Bearer <ONEGATEWAY_API_KEY>' \
  -H 'Content-Type: application/json' \
  -H 'hcd-og-cache-key: faq-demo' \
  -d '{
    "model": "<MODEL_ID>",
    "messages": [{"role": "user", "content": "商品不满意,怎么申请退款?"}],
    "temperature": 0
}'- 首次请求:没有可用条目时返回
og-cache: MISS,成功回答在后台写入。 - 相同请求:等待写入完成后原样重试,命中时返回
og-cache: HIT和og-cache-type: direct。 - 相似请求:启用语义模式后,将问题改为“购买后想退款,需要怎么操作?”,其余条件不变。达到阈值时,命中类型为
semantic。
首次响应后立即重试仍可能 MISS;相似问法也不保证命中。详见排障表。
管理员配置
配置按目标 Gate 实例生效。控制台已接入时,可在对应实例操作;需要直接调用接口时,使用独立的 Gate 管理凭据,参阅完整配置步骤。
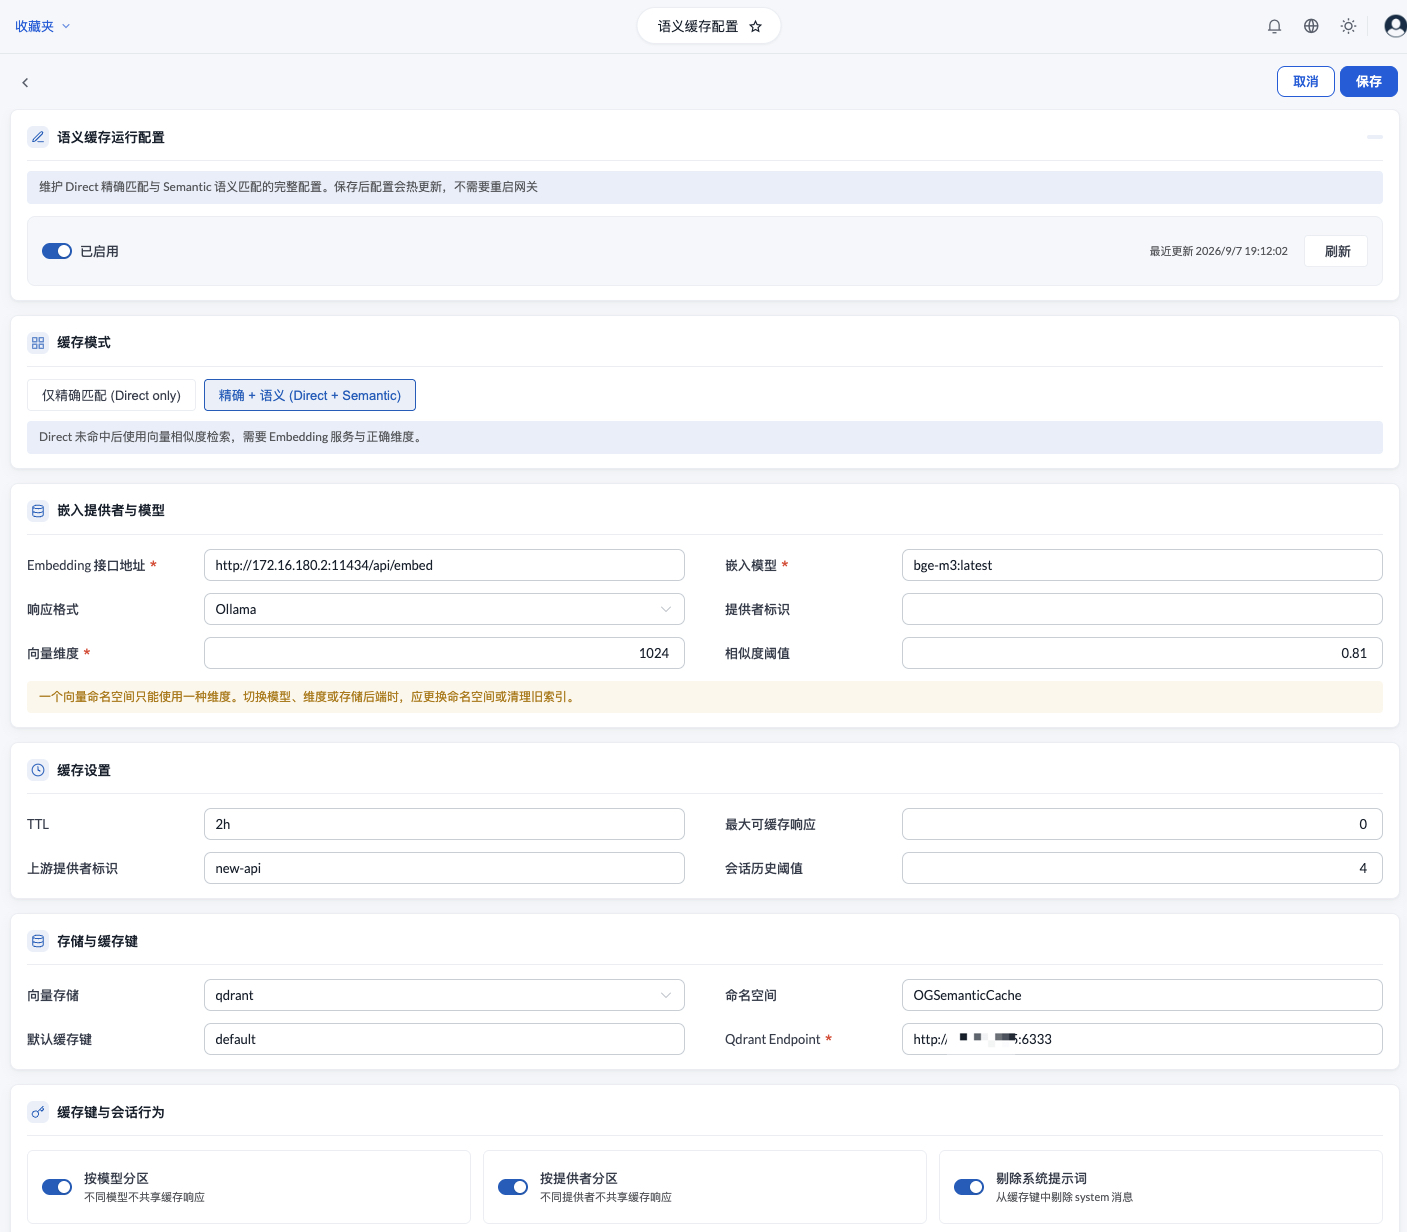
- 配置缓存存储和命名空间,区分测试与生产。
- 选择模式:仅精确模式将
embedding_url留空;语义模式填写完整 Embedding 接口地址、格式、模型、密钥和实际向量维度。 - 设置以下策略,校验并保存,再进行快速验证。
| 配置项 | 默认值 | 说明 |
|---|---|---|
| 缓存有效期(TTL) | 5m | 新条目的有效时长 |
| 相似度阈值 | 0.8 | 越高越严格;不代表回答正确率 |
| 对话历史阈值 | 3 | 按消息条数计算,超出时跳过缓存 |
| 默认缓存键 | 空 | 请求未提供业务键或租户头时使用 |
| 按模型、提供方隔离 | 开启 | 不同模型或提供方分别缓存 |
| 排除系统提示词 | 关闭 | 默认让系统提示词参与匹配及历史计数 |
通常保留默认隔离规则;忽略系统提示词可能复用其他角色设定下的回答。更换 Embedding 模型应使用新命名空间,维度变化还需匹配的集合或索引。
缓存配置支持热更新;失败时保留上一份有效配置,在途请求继续使用原配置。存储字段、配置示例和保存错误处理见技术参考。
按请求控制缓存
| 请求头 | 用法 |
|---|---|
hcd-og-cache-key | 指定业务缓存空间,例如 product-faq:v1 |
hcd-og-ttl | 设置新条目的有效期,例如 30s、5m 或整数秒 |
hcd-og-threshold | 设置语义阈值,范围为大于 0 且不超过 1 |
hcd-og-cache-type | direct 仅精确;semantic 仅语义;默认先精确再语义 |
hcd-og-no-store | true 表示允许读取,但不保存本次回答 |
请求级 TTL 不改变已命中条目的过期时间。非法控制值回退到默认行为;仅语义请求未配置 Embedding 时跳过缓存。完整解析规则见技术参考。
No-Store 仍可能返回旧回答
hcd-og-no-store: true 不会禁止缓存读取或 Embedding 查找。需要重新生成时,使用新的业务缓存键,或由管理员清理相关缓存;若还不希望保存新回答,再配合 No-Store。
缓存空间与匹配边界
缓存空间按以下顺序选择:请求头 hcd-og-cache-key → 请求头 hcd-og-tenant-id 提供的租户标识 → 网关上下文中的用户标识(user:<用户标识>)→ 配置的默认缓存键。只有所有来源都为空时才跳过缓存;用户标识这一层仅在网关上下文已设置该值时使用。
hcd-og-tenant-id 确实是 Gate 支持的请求头,表示业务租户;它不是另一个必须填写的缓存键字段。应用需要显式区分业务场景或答案版本时,使用优先级更高的 hcd-og-cache-key,例如 product-faq:v2。
不同 API 凭据或缓存键不共享缓存;不同接口、流式与非流式也分别缓存。模型、提供方、生成参数、工具和附件等会影响匹配,不能只比较问题文本。精确匹配会归一化文本,并非原始请求逐字节相同。
hcd-og-tenant-id 是调用方可设置的业务标识,不能代替租户授权。多个用户共用一个 API 凭据时,应由可信应用设置业务键和租户头。
凭据形式、归一化和匹配细节见技术参考。
凭据校验与停用验证
配置了上游地址时,缓存前的凭据校验默认启用,有效校验结果默认缓存 5 分钟。停用密钥或账号后,应确认配置已同步,并分别验证原本可命中缓存的请求和需要转发上游的请求均拒绝旧凭据。不要把控制台开关或校验结果缓存时长当作所有路径的撤销生效保证;若仍能取得回答,请管理员检查同步与凭据校验状态。详见缓存前的凭据校验。
生命周期与清理
成功回答在后台写入;流式回答需成功结束,中断的回答不保存。命中不会续期,修改默认 TTL 也不会让旧条目立即失效。关闭或重启 Gate 不主动删除后端条目,存储重启能否保留数据取决于其持久化配置。
清理缓存
知识更新时,可以切换版本化缓存键,例如 product-faq:v1 改为 product-faq:v2,或由管理员清理:
| 方式 | 范围 |
|---|---|
| 按条目 ID | 清除 og-cache-id 对应的回答 |
| 按缓存键 | 清除当前命名空间内该业务键的条目,可能涉及多个 API 凭据 |
清理单条后仍可能命中其他相似条目,在途请求也可能重新写入。完整清理命令和结果验证、配置变更与重启行为见技术参考。
观察效果与排障
先看响应头:
| 响应头 | 含义 |
|---|---|
og-cache | HIT 已命中;MISS 参与查找但未命中 |
og-cache-type | 命中类型:direct 或 semantic |
og-cache-id | 命中的条目 ID,或 MISS 时的候选写入 ID;候选 ID 不保证已保存 |
og-cache-similarity | 语义命中时的相似度 |
管理员可查看命中汇总与请求日志,需启用 logging 插件及 MySQL 日志存储。整体命中率为“精确命中数 + 语义命中数”除以全部已持久化完成请求数,包含跳过缓存的请求。日志和统计可能因异步写入而滞后。
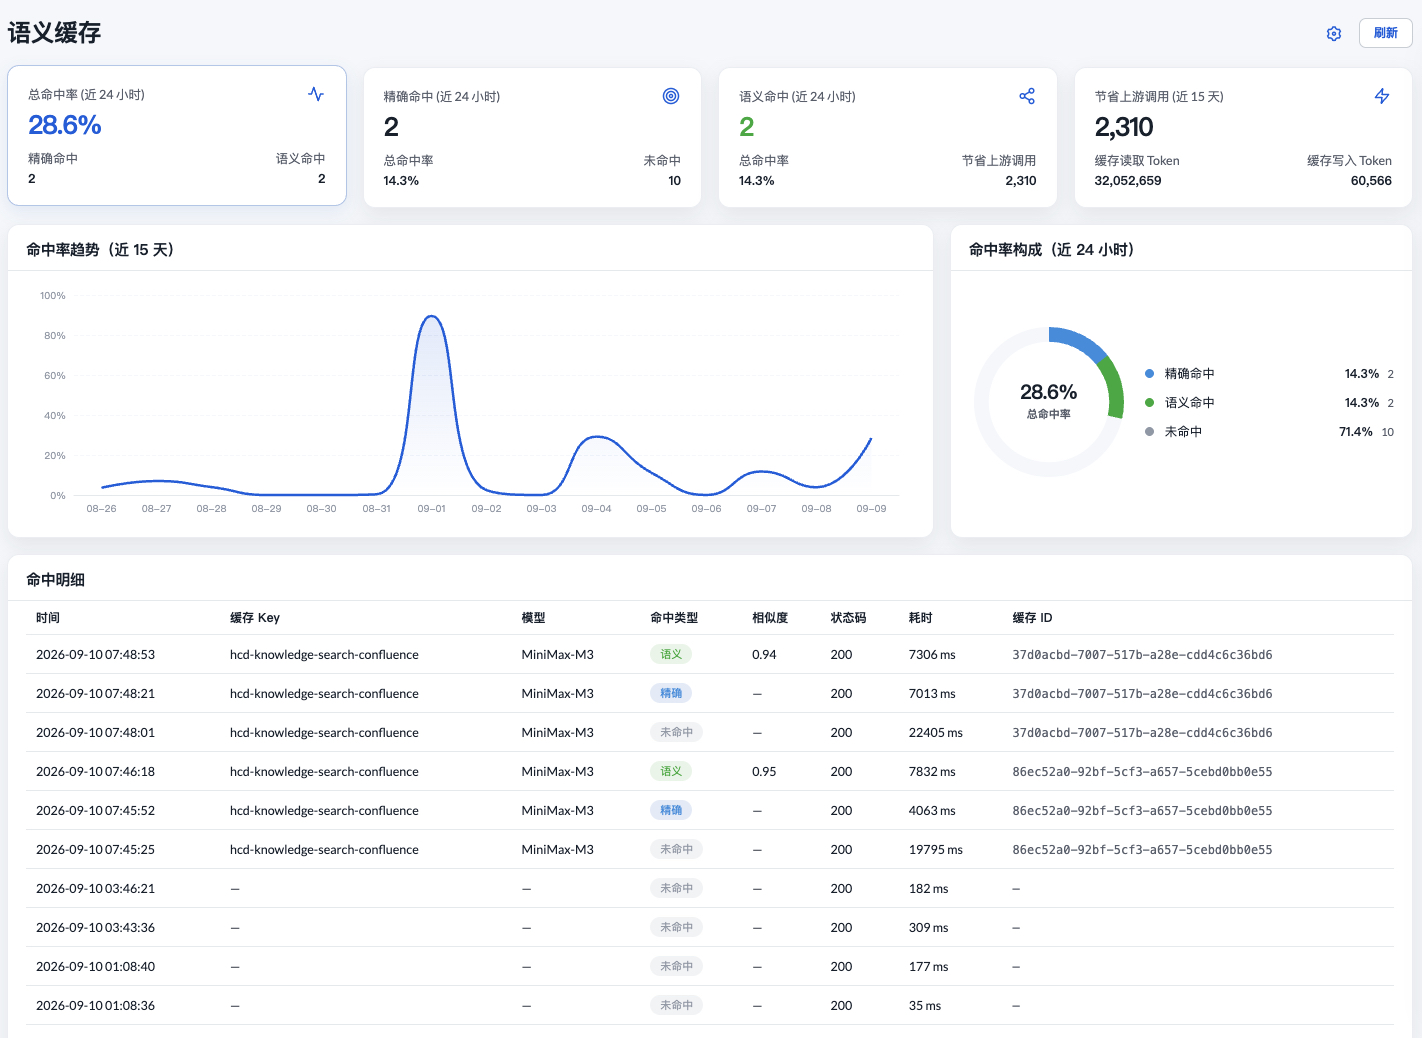
缓存 Token 统计及回放响应中的历史 usage 不代表本次上游消耗,也不能直接计算本次扣费。详见监控参考。
按现象排查
| 现象 | 优先检查 |
|---|---|
没有 og-cache | 是否启用、接口、凭据、缓存键、消息条数,以及代理是否保留响应头 |
| 相同请求持续 MISS | 后台写入是否成功、TTL、前后请求的凭据与参数、No-Store |
| 只有语义匹配不命中 | Embedding 配置、实际维度、匹配边界与阈值;MISS 不保证返回相似度 |
| HIT 仍然较慢 | 缓存前凭据校验和端到端耗时;缓存查找耗时不包含凭据探测 |
| 缓存可用但监控无数据 | logging、MySQL、筛选范围和写入延迟 |
| 清理后仍返回旧回答 | 是否命中另一条、在途写入和存储可见性;知识升级可切换缓存键版本 |
调低阈值可能增加误命中,先用真实业务问题确认答案是否适合复用,再调整。配置保存失败等管理问题,参阅详细排障。
常见问题
语义缓存一定能降低延迟和成本吗?
不一定。命中时可以复用已有回答,减少业务模型的生成调用;语义查找本身需要调用 Embedding 服务,未命中后仍要请求业务模型,因此低命中率场景可能更慢、成本更高。适合优先用于常见问答和答案稳定的业务,并结合命中率与端到端耗时评估效果。
相同问题为什么没有命中缓存?
缓存不仅比较问题文本,还受 API 凭据、缓存键、接口、流式模式、模型和生成参数等影响。首次回答在后台写入,立即重试也可能仍然 MISS;条目过期或请求设置了 No-Store 也会影响后续命中。先确认请求满足缓存条件,再按排障表检查。
相似度阈值为 0.8,代表回答有 80% 的准确率吗?
不是。阈值控制语义相似度匹配,不是答案正确率或置信度。调低阈值可能增加命中,也可能让不同含义的问题复用同一回答。缓存命中后直接返回旧回答,不会针对新问题改写;应使用真实业务问题验证复用是否合适。
如何让某次请求重新生成回答?
使用一个未使用过的 hcd-og-cache-key,或由管理员清理相关缓存。hcd-og-no-store: true 只禁止保存本次回答,仍允许读取已有条目;若希望重新生成且不保存,可同时使用新缓存键与 No-Store。省略缓存键请求头也不保证跳过缓存,因为还可能使用租户头或默认缓存键。
不同用户会共享缓存吗?
不同 API 凭据或缓存键之间不共享条目。若多个用户共用一个 API 凭据且使用同一个缓存键,就可能复用回答;需要隔离时,由可信应用设置不同的业务缓存键。租户头只是业务标识,不能替代授权。详见缓存空间与匹配边界。
知识更新或 TTL 修改后,旧回答会立即失效吗?
不会。修改默认 TTL 不会让旧条目立即过期,命中也不会续期。知识更新时可将缓存键从 product-faq:v1 切换为 product-faq:v2,或清理相关条目;仅删除一条后,仍可能命中其他相似条目。操作方式见清理缓存。
流式回答中断后,会缓存已经生成的部分吗?
不会。流式回答必须成功结束才会写入缓存,中断的部分回答不保存。流式与非流式请求分别缓存,因此切换 stream 后不能期待命中另一种模式的条目。
命中缓存后,响应中的 usage 就是本次消耗吗?
不是。缓存回放中的 usage 是历史响应数据,不代表本次业务模型的上游消耗,也不能直接用于计算本次扣费。缓存 Token 统计同样需要区分历史用量与实际计费。